<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <title>杜屹东的博客</title>
  
  <subtitle>学无止境</subtitle>
  <link href="/atom.xml" rel="self"/>
  
  <link href="https://www.duyidong.com/"/>
  <updated>2020-06-08T15:06:50.095Z</updated>
  <id>https://www.duyidong.com/</id>
  
  <author>
    <name>杜屹东</name>
    
  </author>
  
  <generator uri="http://hexo.io/">Hexo</generator>
  
  <entry>
    <title>杜若生</title>
    <link href="https://www.duyidong.com/2020/06/07/duruosheng/"/>
    <id>https://www.duyidong.com/2020/06/07/duruosheng/</id>
    <published>2020-06-07T18:56:01.000Z</published>
    <updated>2020-06-08T15:06:50.095Z</updated>
    
    <content type="html"><![CDATA[<p>细雨枇杷熟，空江杜若生。</p><a id="more"></a><p>杜若是一种香草，七月开花九月结果，五六月正是生长的时候。</p><p>小名小满，意为满意、圆满。小满也是五月底一个节气，暖湿气流活跃，雨水开始增多，往往会出现持续大范围的强降水，江河渐满，也是杜若生的时候。</p><p><img src="/images/RuoshengDU.jpg" alt=""></p><blockquote><p>Thanks for give me one more reason to be a better man.</p></blockquote>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;细雨枇杷熟，空江杜若生。&lt;/p&gt;
    
    </summary>
    
      <category term="我的博客" scheme="https://www.duyidong.com/categories/%E6%88%91%E7%9A%84%E5%8D%9A%E5%AE%A2/"/>
    
    
  </entry>
  
  <entry>
    <title>一个项目的诞生</title>
    <link href="https://www.duyidong.com/2020/02/15/project-start-in-alicloud/"/>
    <id>https://www.duyidong.com/2020/02/15/project-start-in-alicloud/</id>
    <published>2020-02-15T22:31:43.000Z</published>
    <updated>2020-02-18T08:26:26.786Z</updated>
    
    <content type="html"><![CDATA[<p>以一个开发的视角讲述一个阿里云产品从孵化到上线的都经历了些什么，哪些方面可以做得更好。</p><a id="more"></a><h1 id="过程"><a href="#过程" class="headerlink" title="过程"></a>过程</h1><h2 id="需求讨论"><a href="#需求讨论" class="headerlink" title="需求讨论"></a>需求讨论</h2><p>一个项目的开始并不是一开始就有团队大部分角色和明确的需求，很可能连产品经理都没有，只有一个项目负责人带领两三个开发代表各个利益相关的团队把各自的需求搜集整理，通过一次又一次的会议沟通整理最终勾勒出产品的轮廓。</p><p>就像一个怀孕初期的婴儿连五官都还没有清晰，这个时候往往不知道谁是产品的 Stackholder，所有人包括项目负责人都有可能中途退出，有可能已经定下来的核心需求老板一句话就要作废，项目随时会因为预算、HC、其他更高优先级的需求流产；这个阶段最重要的是阐明产品的价值、找到愿意为项目埋单的老板，为产品争取争取尽可能多的资源，包括人力、时间，有了这些资源，项目不一定会成功，但是没有这些资源项目一定做不起来。</p><p>这个阶段最需要的几种能力：</p><ul><li>是向上管理，推动老板争取到资源</li><li>很强的产品逻辑和领域知识，在不同团队利益冲突时你可以说话最大声，告诉他们这个领域的趋势是什么，头部产品是怎么做的，应该如何在需求中取舍</li><li>过硬的技术能力和经验，和对已有架构的熟悉，往往是在考虑实现阶段体现出价值；熟悉已有架构可以从如何复用已有资源、如何集成的角度用投入产出比影响需求优先级</li></ul><p>除了争取到资源，设计阶段还有一个重要产出，就是<strong>”产品抓手“</strong>，即围绕核心业务一个最常见最简单的 happy pass，为后续开发联调设置一个目标。</p><h2 id="架构设计"><a href="#架构设计" class="headerlink" title="架构设计"></a>架构设计</h2><p>有了大致的需求方向，和从老板那里争取到的人力，三两个开发就可以开始初始的架构设计了。这里的架构设计主要是：划分应用、表设计、接口设计。</p><p>在 DDD 语境下领域模型的识别是重要的一环，在阿里巴巴却只注重数据库表结构设计，对于这种现象的解释这里有一篇文章我认为说得很有道理：<a href="https://blog.csdn.net/m0_37609579/article/details/102961765" target="_blank" rel="noopener">为啥国人偏爱Mybatis，而老外喜欢Hibernate/JPA呢？</a>，我比较认同其中 Mybatis 更加拥抱变化的观点，但缺点是设计的时候太开放太灵活而失去了面向对象、领域驱动的优雅。不过事实证明，这样的开放的设计确实可以应对随后而来的各种意料之外的需求。产品是一边演进一边被定义的，一开始就想要做好领域设计并不容易，很可能一开始认为的核心业务也会随着项目变化而发生转移。不过这种模式也带来一个弊端，就是经过反复改造的应用生命周期不长，一个三年的应用一旦 Owner 离职或转岗则很有可能面临被重写的命运。也正是因为生命周期不长，代码质量和测试覆盖的受重视程度并不高。三年过后很有可能项目都不在了，有多少人会在意那个时候代码还是否能维护呢？</p><p>这个阶段需要的几种能力：</p><ul><li>对业务的透彻理解，有助于划分应用以及应用持久化数据的设计</li><li>数据库基础知识，涉及到表之间的关联关系、索引如何建立</li></ul><h2 id="开发联调"><a href="#开发联调" class="headerlink" title="开发联调"></a>开发联调</h2><p>我一直秉持一个观点，联调要越早越好，即使文档化的接口在不同团队不同开发实施出来也可能大相径庭，及早联调及早暴露问题也是风险管控的重要一环。</p><p>联调依赖的是需求讨论阶段的抓手的，大家都朝着快速实现这个目标前进才能确保方向没有偏差，实现小步快跑的第一步。</p><p>这个阶段最需要的是推动所有相关开发尽快跑通 happy pass，让联调尽可能早地发生，每次联调完之后确定待修复 bug 以及下一次联调需要验收的功能。后期的联调如果可能的话还得 involve 产品和设计，尽可能多地对上线前的产品做一些引导。</p><h2 id="功能迭代"><a href="#功能迭代" class="headerlink" title="功能迭代"></a>功能迭代</h2><p>联调之后产品就可以上线第一个版本了，同步进行的是功能迭代。项目进行到这里 StackHolder 已经比较明确，也有了产品的介入，开发团队也比较稳定，大部分开发团队长期处于这个阶段。</p><p>这个阶段伴随着应用的演化，应用架构越来越完善，数据库结构变化越来越小，上线之后的应用由于一些数据不可能再改变而成为一个较为成熟的应用。</p><p>这个阶段需要的能力主要就是对框架、语言、以及设计模式比较熟悉，能够快速优雅的实现需求基于原有设计模式进行扩展，或者在实现新功能的时候预留出一些扩展。</p><p>这个阶段容易出现的问题是团队成员沟通不充分导致的重复造轮子，一条链路下原有的扩展点没有被利用而又新增扩展点；给应用应塞入一些不相干的功能，随着团队人员流动，这两种现象是应用生命缩短的杀手。最好的缓解方式就是做好新人 on boarding、文档沉淀，以及新方案落地前团队内部的技术方案对齐。</p><h2 id="Bug-收敛，稳定性、容错性提升"><a href="#Bug-收敛，稳定性、容错性提升" class="headerlink" title="Bug 收敛，稳定性、容错性提升"></a>Bug 收敛，稳定性、容错性提升</h2><p>功能完善之后有了运营的介入，这个时候会拉来一些种子用户进行”共创“，即公测前的试用，我们满足种子用户的大部分需求，用户帮我们发现大部分 bug。这个阶段发生在预期功能完成后的阶段，主要包含以下工作：</p><ul><li>监控预警：从业务层到应用层到基础设施逐级监控，目标在于在客户发现问题前发现问题：<ul><li>基础设施：服务器 CPU、内存、磁盘、负载均衡监控、</li><li>应用层：RT (response time，主要为 nginx 日志)、端口心跳（最好由应用提供而不是 nginx）、Nginx 返回码监控、数据库连接池、JVM 监控、慢 SQL</li><li>业务监控：失败成功率；可能涉及侵入代码的逻辑，再通过配置 logback 给 agent 搜集到业务监控服务。主要形式还是日志。</li></ul></li><li>日志追溯：主要是为了出现问题容易定位，有以下几个实践我认为是比较好的：<ul><li>一次不同应用之间由 traceId 串联，具体做法参考我的上一篇博客<a href="https://www.duyidong.com/2019/12/21/spring-boot-log-trace/">Spring boot 全局参数传递和追踪</a></li><li>适当存储一些状态到数据库，配合日志查看帮助判断当前状态或是影响面</li><li>还有一些更高级的基于 JVM 的追踪工具，比如 <a href="https://github.com/apache/skywalking" target="_blank" rel="noopener">skywalking</a> 用于查看调用链路和，极大提升了定位问题效率。</li></ul></li><li>安全性升级</li></ul><p>这个阶段需要具备的能力偏向运维：</p><ul><li>从操作系统到网络层的基础知识</li><li>安全方面的经验和知识</li><li>各种DevOps工具</li></ul><h2 id="性能提升"><a href="#性能提升" class="headerlink" title="性能提升"></a>性能提升</h2><p>有了完善的监控，我们对系统的整体表现有了一个比较好的掌握，就该针对性的做一些优化。以一个 RT issue 为例，当我们发现某接口长时间返回时间较长，首先通过 Skywalking 判断慢在哪个服务；第二部通过 Nginx 确定耗时任务是在应用内部（而不是DNS、网关或负载均衡器）；第三步使用 <a href="https://alibaba.github.io/arthas/" target="_blank" rel="noopener">Arthas</a>（参见<a href="https://www.duyidong.com/2019/11/26/arthas-analytics-rt/">使用 Arthas 分析接口响应时间</a>），定位到慢的地方（通常是 IO 操作，比如慢 SQL）；第四步通过基础设施监控进一步判断问题，比如慢 SQL 是否真的存在，或者负载均衡配置需要优化；最后通过加索引或者优化配置的方式优化用户体验。再进行端到端验证问题是否已解决。</p><p>技术性的性能提升通常比较简单，比较复杂的往往是业务相关的性能提升，我们的服务是基于容器的，容器的调度、资源复用、配置成为了最有价值的优化点，这部分跟业务强依赖没太多共性，就不展开了。</p><h1 id="感受"><a href="#感受" class="headerlink" title="感受"></a>感受</h1><ul><li>稳定压倒一切。</li><li>团队协作/资源协调，整个过程伴随着人员、利益相关团队流动。</li><li>安全无处不在，每个环节都在体现安全。</li></ul><h1 id="反思"><a href="#反思" class="headerlink" title="反思"></a>反思</h1><ul><li><p>每个阶段定好时间，定好验收内容</p><p>无论是个人还是团队，如果只顾着忙于日常工作就容易走偏，或者陷入细节，最终达不到业绩目标。因此在开始一件事之前定好期望结果很重要，就跟TDD一样，团队开始规划前也要定好验收条件（也就是 KPI，通常是业务指标），一个好的节点验收计划可以帮助项目一步步达到理想的结果。</p></li><li><p>文档真的很重要</p><p>最近恰好看到一篇博客<a href="https://evanliman.to/2019/10/06/so-youre-a-new-grad-software-engineer.html" target="_blank" rel="noopener">So You’re A New Grad Software Engineer</a>，提到一个团队新人除了技术积累写好文档可能比写好代码更重要，非常赞同，从 commit message 到 README 到产品文档，写好文档除了帮助后来的人理解设计者意图也能帮助你成为某个知识领域的专家，从而让你被更多人找到问问题，不仅帮助了问问题的人也帮助了你自己。把软件开发想象成一个知识翻译的过程，文档是比代码更易于传递的知识中间态。</p></li><li><p>贴近用户</p><p>直面用户可能会很痛苦，因为你们不在同一个上下文，沟通起来会比较费劲。但耐心地去做这件事，并且坚持做，能更好地帮助你站在用户视角考虑问题，当一个用户带着问题通过工单，通过答疑，通过运营到达你面前，他面临的一定是一个对他而言痛到一定程度的痛点，这个痛点就是一次产品提升的机会。</p></li></ul>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;以一个开发的视角讲述一个阿里云产品从孵化到上线的都经历了些什么，哪些方面可以做得更好。&lt;/p&gt;
    
    </summary>
    
      <category term="阿里巴巴" scheme="https://www.duyidong.com/categories/%E9%98%BF%E9%87%8C%E5%B7%B4%E5%B7%B4/"/>
    
    
      <category term="小结" scheme="https://www.duyidong.com/tags/%E5%B0%8F%E7%BB%93/"/>
    
      <category term="工作" scheme="https://www.duyidong.com/tags/%E5%B7%A5%E4%BD%9C/"/>
    
  </entry>
  
  <entry>
    <title>这一年我在阿里学到的</title>
    <link href="https://www.duyidong.com/2020/01/01/2019-learn-from-alibaba/"/>
    <id>https://www.duyidong.com/2020/01/01/2019-learn-from-alibaba/</id>
    <published>2020-01-02T03:03:48.000Z</published>
    <updated>2020-01-01T14:33:55.836Z</updated>
    
    <content type="html"><![CDATA[<p><img src="/images/2019-commits.jpeg" alt=""></p><a id="more"></a><p>2019 年在项目中的 commit 记录，一共有 2589 次提交，涉及到 28 个代码库，23 个应用的 344 个需求。</p><h1 id="如何和老板沟通"><a href="#如何和老板沟通" class="headerlink" title="如何和老板沟通"></a>如何和老板沟通</h1><p>和老板沟通其实是种向上管理的能力。有前辈云，在阿里最重要的两件事：跟对人，做对事。做对事指的是做到好的项目，跟对人就是跟一个好的老板。很多人离开阿里的时候感叹，被 NB 的公司吸引来，被 SB 老板气走。老板不仅决定你的晋升、绩效和奖金，还是决定你工作是否开心、职业道路上是否有成长的重要因素。</p><ul><li><p>及时和老板表达想法</p><p>在阿里老板这么重要，颇有官大一级压死人的感觉。作为“下级”容易有一种思维：老板交代的事情只能执行，即使不太想做，咱也不敢说，咱也不敢问。这样的事如果是小任务可能问题不大，但长期如此，对自己是拖累，对任务是风险。比如刚入职的一段时间我被安排到一个数据运营的项目里面，这个任务技术上只是在前端加一些埋点，剩下的大部分时间是和产品、数据的同事讨论如何调整埋点。这个需求不属于我的 KPI，stackholder 主要是产品，但又有许多没什么技术含量的工作要做，主要是操作阿里的各种内部系统做一些配置，这些系统往往缺少文档或者面临更新换代，易用性、稳定性和容错性都不理想，有较高的上手成本，最重要的是在这项工作中我认为自己得不到想要的成长，这个时候就会表现出来任务进展缓慢，对任务缺少 ownership，在晨会上更新状态的时候只能说到埋了一些点的表面，而不能站在任务视角更新整体进度。老板观察到这种状况，只能做两种猜测：一种是这个人能力不行，交给他的事 handle 不了，另一种是他能力是没问题的，只是不喜欢做这个项目。当你和老板之间有足够的信任的时候，老板的猜测可能会倾向于后者，但如果老板多次尝试你都不 say no 又做不好，老板自然会对你失去信心，这是我们不希望得到的结果。而且老板那么忙，为什么要老板去猜呢？自己说出来不是更好吗，老板分配任务的时候并不是定死了你做 A，给他做 B，也是站在一个统筹的角度，尽可能把任务分配给适合的人做，让老板听到你的声音，其实是帮助老板做出最优选择。所以与其含含糊糊地把任务接下来不好好做，不如主动说，提前说，既有利于自己，又规避了项目风险。老板对你的兴趣了解得越多，你也越容易得到适合自己的任务。</p></li><li><p>让老板知道你在忙什么</p><p>一个开发团队的杂事是很多的，老板不可能时时刻刻知道每个人在忙什么，这个时候就需要个人对上级有一个主动的工作内容汇报，包括你在做什么事情，进度如何，风险点在哪。千万不要一个人瞎忙，例如帮助其他团队的同事做联调、或者协助设计的工作，这些职责之外的事情，也要透明出来，老板才不不会觉得你上班是在摸鱼。千万不要等到老板质疑你开发效率低的时候再提，尽早避免误会。阿里内部有个写周报的要求，我觉得是一种有用的方式。</p></li><li><p>主动帮老板做一些脏活累活</p><p>前面两点都是让老板了解你，你也得了解你的老板，站在老板的角度考虑问题永远是利大于弊的。尤其当你的老板是一个技术角色，他的位置很有可能就是你的下一个职业目标。知道你的老板在想什么，解决老板头疼的问题，既有利于提升自己的能力，又有利于提升在老板心中的地位，说的现实些，一个团队的开发大家平时都在写业务，拿什么体现你比别人的工作更有价值？不就是看你为团队多操了哪些心嘛，什么集成测试挂了没人修，代码合并老是冲突是不是该换分支策略了，测试环境部署的时候怎么有宕机时间了，对这些这些看似项目以外的事情关心，恰巧是体现出差距的地方，更不用说老板操心的事情，一定是会让团队发展受阻的，也就是更有价值的事情。</p></li></ul><h1 id="做好并行任务管理"><a href="#做好并行任务管理" class="headerlink" title="做好并行任务管理"></a>做好并行任务管理</h1><p>在日常工作中，迭代任务主要是业务需求，除了处理这些需求之外每天往往还会有一些紧急的 bug fix，领导立马要的、客户新提的、产品认为要赶紧上、运营突然想要调整的的需求，诸如此类的临时任务。这些任务我在排优先级的时候有两个原则：紧急的事情优先于迭代的需求，有外部依赖的事情优先于自己能搞定的事情。</p><ul><li><p>异步工作模式，沟通先行</p><p>作为开发日常工作中很多任务是有第三方依赖的，涉及到其他产品，或者团队，这些依赖方的反馈周期和 push 难易程度肯定要大于团队内协作的情况，因此把他们放在首位，优先解决项目中不确定性大的部分，主要是为了规避项目不能按时交付的风险，同时给其他团队留够时间也是一种 push 的技巧。一个需求我问你要了两天没给我跟两周没给我是不一样的。</p></li><li><p>利用好项目管理工具</p><p>异步任务最难的是任务挂起后一段时间，唤醒的时候还能拿到所有的上下文，这个时候就要有好的项目管理工具支持，看板是一种，可以在任务卡的评论里留下足够详细的进展记录，方便在多任务同步进行的情况下追溯具体任务的细节。</p></li><li><p>做好任务可视化，即时同步相关责任人</p><p>做好可视化，除了让你的老板知道你在忙什么，还能为你争取到一些资源，比如站会时更新状态的时候可能会有团队成员提出之前做过类似的事情，或者给你发篇文档，或者给你个靠谱的接口人，都能极大地提升你的办事效率，扫除项目中的不确定因素。</p></li></ul><p>至于自己能搞定的事情，如果真是有那么着急，即使其他团队的人都走了，正好也没人会打扰到你，这个时候再做，其实是更有效率的。</p><blockquote><p> 凡事有交代，件件有着落，事事有回应。</p><p style="text-align:right">——判断一个人是不是靠谱的三个标准</p></blockquote><h1 id="高效会议"><a href="#高效会议" class="headerlink" title="高效会议"></a>高效会议</h1><p>在阿里的会议主要有周会和项目对齐需求的会议，团队内部的沟通一般吼一声就可以，所以会议大多是面向老板的或是面向其他部门。其实在 <a href="https://www.duyidong.com/2018/10/24/from-thoughtworks-to-alibaba/">ThoughtWorks 的离职总结</a>我有提到过如何做一个好的会议组织者，在这一年的工作中我更多的时候是作为一个参与者。会议的组织者主要是关心会议的目的，会议的议程是什么，哪些是会议主题之外应该私下讨论的，会议到达达成的共识是什么，诸如此类；作为一个参与者，更多的是要关注自己的目的，要和谁确认清楚什么事情，要某位领导点头做某个决定或者不做，带着目的去开会是高效会议最重要的核心。</p><ul><li>开会要准备，会议的背景、有哪些内容是“你”一定要在会上和别人沟通清楚的，有哪些是可以线下再说的。</li><li><p>一切讨论、想法都要有记录。</p></li><li><p>邮件比聊天工具更适合工作。</p></li></ul><h1 id="及早发现问题，快速获得反馈"><a href="#及早发现问题，快速获得反馈" class="headerlink" title="及早发现问题，快速获得反馈"></a>及早发现问题，快速获得反馈</h1><p>返工是最耽误进度的，曾经有过一段不愉快的项目经历，是因为一个产品需求上的一个小变动导致整个技术方案推倒重来，而且因为一开始没有预估好变动的范围采取了基于第一版的实现改造的方式，导致工期比重做一版还长，最终影响到项目交付时间比预期延长了一倍。这些损失和风险其实是可以通过及时、频繁的沟通降低的，协作的核心就是在沟通，宁愿在开始前先花时间沟通清楚业务需求和技术实现，也不要造成返工这种极大的浪费。</p><h1 id="直面客户"><a href="#直面客户" class="headerlink" title="直面客户"></a>直面客户</h1><p>阿里巴巴一以贯之的价值观是“客户第一”。在一个云产品团队，我们的客户主要是用户企业的开发者。以前在 ThoughtWorks 很苦恼的是总是要通过客户企业才能接触到真正的用户，在阿里的苦恼是每天都要接触真正的用户。刚开始答疑的时候，内心是很排斥的，一方面由于用户的技术能力参差不齐，提的问题大多涉及到非产品的问题而是一些通用开发工具如 npm, maven 的使用上的问题，让人很想甩用户一脸“自己 Google”。然而价值观告诉我们这样是不对的，耐着性子跟客户聊下来发现，很多问题源自于用户和我们不在同一个上下文，产品背后的实现对用户而言是一个黑盒，所以提出来的问题很多会让我们觉得很无语，而且随着沟通的深入我还发现，其实用户反馈的问题中，有相当一部分确实是我们的问题，要么是易用性，比如错误提示做得不够好，要么是产品真的有 bug。认真对待客户的问题是一个做产品的团队应有的心态，阿里云作为一个庞大的系统有自己的用户反馈体系，用户的声音经过层层传递到达开发团队是很不容易的，是用户的信任让他的问题走到了我们面前，不要辜负这份信任。</p><h1 id="小结"><a href="#小结" class="headerlink" title="小结"></a>小结</h1><p>最后，Ownership 真的是太重要，可能是职场中最重要的东西。有责任感，交给你一件事做成了，又交给你一件事也做成了，你做的事情会越来越多，越来越有挑战，这个过程就叫成长。</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;&lt;img src=&quot;/images/2019-commits.jpeg&quot; alt=&quot;&quot;&gt;&lt;/p&gt;
    
    </summary>
    
      <category term="学习总结" scheme="https://www.duyidong.com/categories/%E5%AD%A6%E4%B9%A0%E6%80%BB%E7%BB%93/"/>
    
    
      <category term="大事记" scheme="https://www.duyidong.com/tags/%E5%A4%A7%E4%BA%8B%E8%AE%B0/"/>
    
  </entry>
  
  <entry>
    <title>Spring boot 全局参数传递和追踪</title>
    <link href="https://www.duyidong.com/2019/12/21/spring-boot-log-trace/"/>
    <id>https://www.duyidong.com/2019/12/21/spring-boot-log-trace/</id>
    <published>2019-12-21T18:25:01.000Z</published>
    <updated>2019-12-22T04:43:17.140Z</updated>
    
    <content type="html"><![CDATA[<p>本文介绍如何基于 spring boot 获取、传递、使用一次会话的全局参数，并在所有链路日志中打印。</p><a id="more"></a><h1 id="支持场景"><a href="#支持场景" class="headerlink" title="支持场景"></a>支持场景</h1><ul><li>微服务中使用 traceId 实现跨应用日志追踪 。</li><li>用户认证信息传递。</li><li>和全局参数有关的日志追踪。</li></ul><h1 id="具体实现"><a href="#具体实现" class="headerlink" title="具体实现"></a>具体实现</h1><h2 id="TraceId-获取"><a href="#TraceId-获取" class="headerlink" title="TraceId 获取"></a>TraceId 获取</h2><p>在决定在什么位置获取 traceId 之前先看一下 Tomcat 容器中 Servlet、Filter 、 Listener 和 Interceptor 的关系：</p><p><img src="/images/tomcat-container.png" alt=""></p><center><strong>图片来源：<a href="https://blog.csdn.net/xuemengrui12/article/details/98783715" target="_blank" rel="noopener">https://blog.csdn.net/xuemengrui12/article/details/98783715</a></strong></center><p>在选择获取 traceId 的时候我希望他是一个全局的，对所有请求生效的配置，因此放在 Filter 层，下面尝试在 Filter 中打印出 traceId:</p><p><strong>ContextFilter.java</strong></p><pre><code class="java">@Component@Order(Ordered.HIGHEST_PRECEDENCE)@Slf4jpublic class ContextFilter implements Filter {    @Override    public void doFilter(ServletRequest servletRequest, ServletResponse servletResponse, FilterChain filterChain)        throws IOException, ServletException {        HttpServletRequest request = (HttpServletRequest) servletRequest;        Enumeration&lt;String&gt; headerNames = request.getHeaderNames();        String traceId = request.getHeader(&quot;Trace-Id&quot;);        if (StringUtils.isNotBlank(traceId)) {            log.info(traceId);        }        filterChain.doFilter(servletRequest, servletResponse);    }    @Override    public void init(FilterConfig filterConfig) throws ServletException {    }    @Override    public void destroy() {    }}</code></pre><h2 id="全局参数传递"><a href="#全局参数传递" class="headerlink" title="全局参数传递"></a>全局参数传递</h2><p>验证完获取 traceId 之后，我们需要把 traceId 在一个次会话中传递，先使用 Thread local 实现：</p><p><strong>AppContext.java</strong></p><pre><code class="java">public class AppContext implements Serializable {    public static final String TRACE_ID_HEADER = &quot;Trace-Id&quot;;    private static final long serialVersionUID = -979220111440953115L;    private String traceId;    private static final ThreadLocal&lt;AppContext&gt; LOCAL = ThreadLocal.withInitial(AppContext::new);    public static AppContext getContext() {        return LOCAL.get();    }    public static void setContext(AppContext context) {        LOCAL.set(context);    }    public static void removeContext() {        LOCAL.remove();    }    public String getTraceId() {        return traceId;    }    public void setTraceId(String traceId) {        this.traceId = traceId;    }}</code></pre><p>有了 Thread local 对象，就可以实现随用随取了，类似的，用户信息也可以用这种方式隐式传递。</p><pre><code class="java">AppContext.getContext().setTraceId(traceId); # 在 Filter 中将 traceId 存入 thread localAppContext.getContext().getTraceId();        # 在 controller 中取出 traceId</code></pre><h2 id="多线程全局参数传递"><a href="#多线程全局参数传递" class="headerlink" title="多线程全局参数传递"></a>多线程全局参数传递</h2><p>Thread local 可以优雅地实现 Session 管理，但仅仅局限在一个封闭线程内，在使用线程池等会池化复用线程的执行组件情况下 Thread local 的信息就会丢失，例如我们在获取用户信息的地方加入一个线程池：</p><p><strong>UserService.java</strong></p><pre><code class="java">private static final ExecutorService SAVE_USER_THREAD_POOL = Executors.newFixedThreadPool(5);public User getUser(Long userId) throws InterruptedException, ExecutionException {        log.info(&quot;[{}]Get user by id={}&quot;, AppContext.getContext().getTraceId(), userId);        try {            return GET_USER_THREAD_POOL.submit(() -&gt; userRepository.getUserById(userId)).get();        } catch (ExecutionException e) {            Throwable t = e.getCause();            if (t instanceof CommonException) {                throw (CommonException)t;            }            throw e;        }    }</code></pre><p>这时候再来测试一下：</p><pre><code class="bash">curl -H &#39;Trace-Id:123&#39; localhost:8080/user?id=3</code></pre><p><img src="/images/fail-transter-context.png" alt=""></p><p>可以看到，进入线程池之前的 UserService 中是可以打印出 traceId 的，但是在线程池中的 UserRepository 渠道的 traceId 则为 null，正是由于 Thread local 无法实现跨线程传递。<a href="https://github.com/alibaba/transmittable-thread-local" target="_blank" rel="noopener">TTL</a> 帮我们解决了这个问题，可以把把任务提交给线程池时的 Thread local 值传递到 任务执行时：</p><p><strong>AppContext.java</strong></p><pre><code class="java">private static final TransmittableThreadLocal&lt;AppContext&gt; LOCAL = new TransmittableThreadLocal&lt;AppContext&gt;() {        @Override        protected AppContext initialValue() {            return new AppContext();        }    };</code></pre><p>再运行一次，可以看到线程池中也可以获取到全局变量 traceId 了：</p><p><img src="/images/success-transfer-context.png" alt=""></p><h2 id="单元测试"><a href="#单元测试" class="headerlink" title="单元测试"></a>单元测试</h2><p>TTL 好用，可是当隐式传递的 Session 信息无孔不入地被应用到业务逻辑的时候，如果对 Thread local 对象添加单元测试成了不得不面对的问题，下面给出一种方式：Mock Context 对象的静态方法：</p><p><strong>pom.xml</strong></p><pre><code class="xml">&lt;dependency&gt;            &lt;groupId&gt;junit&lt;/groupId&gt;            &lt;artifactId&gt;junit&lt;/artifactId&gt;            &lt;version&gt;4.12&lt;/version&gt;            &lt;scope&gt;test&lt;/scope&gt;        &lt;/dependency&gt;        &lt;dependency&gt;            &lt;groupId&gt;org.powermock&lt;/groupId&gt;            &lt;artifactId&gt;powermock-module-junit4&lt;/artifactId&gt;            &lt;version&gt;2.0.4&lt;/version&gt;            &lt;scope&gt;test&lt;/scope&gt;        &lt;/dependency&gt;        &lt;dependency&gt;            &lt;groupId&gt;org.powermock&lt;/groupId&gt;            &lt;artifactId&gt;powermock-api-mockito2&lt;/artifactId&gt;            &lt;version&gt;2.0.4&lt;/version&gt;            &lt;scope&gt;test&lt;/scope&gt;        &lt;/dependency&gt;</code></pre><p><strong>UserServiceTest.java</strong></p><pre><code class="java">@RunWith(PowerMockRunner.class)@PrepareForTest(AppContext.class)public class UserServiceTest {    private static final long CONTEXT_USER_ID = 123L;    private static final String CONTEXT_TRACE_ID = &quot;trace-id&quot;;    @InjectMocks    private UserService userService;    @Mock    private UserRepository userRepository;    @Before    public void setUp() throws Exception {        AppContext context = new AppContext();        context.setTraceId(CONTEXT_TRACE_ID);        context.setUserId(CONTEXT_USER_ID);        PowerMockito.mockStatic(AppContext.class);        BDDMockito.given(AppContext.getContext()).willReturn(context);    }    @Test    public void shouldReturnUserWhenUserIdInContext() throws ExecutionException, InterruptedException {        // given        when(userRepository.getUserById(eq(CONTEXT_USER_ID))).thenReturn(new User(CONTEXT_USER_ID, &quot;userName&quot;));        // when        User user = userService.getCurrentUser();        // then        Assert.assertEquals(Long.valueOf(123), user.getId());        Assert.assertEquals(&quot;userName&quot;, user.getName());    }}</code></pre><h2 id="日志中打印全局参数"><a href="#日志中打印全局参数" class="headerlink" title="日志中打印全局参数"></a>日志中打印全局参数</h2><p>在上文的日志中我使用 <code>log.(&quot;[{}]&quot;, traceId)</code>的方式在日志中加入全局参数，事实上很多情况下我们是想随时知道全局参数的变量值的，怎么避免每次重复地写打印全局变量日志的方式呢？log4j 和 logback 提供的一种方便在多线程条件下记录日志的功能：MDC（Mapped Diagnostic Context，映射调试上下文） 。</p><p>只需要在日志模板中加入 <code>%X{traceId}</code>，再在适当的位置把 traceId 放入 <code>org.slf4j.MDC</code> 中即可：</p><p><strong>logback-spring.xml</strong></p><pre><code class="xml">&lt;?xml version=&quot;1.0&quot; encoding=&quot;UTF-8&quot;?&gt;&lt;configuration&gt;    &lt;!-- https://github.com/spring-projects/spring-boot/blob/v1.5.13.RELEASE/spring-boot/src/main/resources/org/springframework/boot/logging/logback/defaults.xml --&gt;    &lt;include resource=&quot;org/springframework/boot/logging/logback/defaults.xml&quot; /&gt;    &lt;property name=&quot;FILE_LOG_PATTERN&quot; value=&quot;%d{yyyy-MM-dd HH:mm:ss.SSS} ${LOG_LEVEL_PATTERN:-%5p} [%t] [traceId:%X{traceId}] %-40.40logger{39} : %m%n${LOG_EXCEPTION_CONVERSION_WORD:-%wEx}&quot;/&gt;    &lt;property name=&quot;CONSOLE_LOG_PATTERN&quot; value=&quot;%d{yyyy-MM-dd HH:mm:ss.SSS} ${LOG_LEVEL_PATTERN:-%5p} [%t] [traceId:%X{traceId}] %-40.40logger{39} : %m%n${LOG_EXCEPTION_CONVERSION_WORD:-%wEx}&quot;/&gt;    &lt;property name=&quot;APP_NAME&quot; value=&quot;global-param-trace&quot; /&gt;    &lt;property name=&quot;LOG_PATH&quot; value=&quot;${user.home}/${APP_NAME}/logs&quot; /&gt;    &lt;property name=&quot;LOG_FILE&quot; value=&quot;${LOG_PATH}/application.log&quot; /&gt;    &lt;appender name=&quot;APPLICATION&quot;              class=&quot;ch.qos.logback.core.rolling.RollingFileAppender&quot;&gt;        &lt;file&gt;${LOG_FILE}&lt;/file&gt;        &lt;encoder&gt;            &lt;pattern&gt;${FILE_LOG_PATTERN}&lt;/pattern&gt;        &lt;/encoder&gt;        &lt;rollingPolicy class=&quot;ch.qos.logback.core.rolling.SizeAndTimeBasedRollingPolicy&quot;&gt;            &lt;fileNamePattern&gt;${LOG_FILE}.%d{yyyy-MM-dd}.%i.log&lt;/fileNamePattern&gt;            &lt;maxHistory&gt;7&lt;/maxHistory&gt;            &lt;maxFileSize&gt;50MB&lt;/maxFileSize&gt;            &lt;totalSizeCap&gt;20GB&lt;/totalSizeCap&gt;        &lt;/rollingPolicy&gt;    &lt;/appender&gt;    &lt;appender name=&quot;CONSOLE&quot; class=&quot;ch.qos.logback.core.ConsoleAppender&quot;&gt;        &lt;encoder&gt;            &lt;pattern&gt;${CONSOLE_LOG_PATTERN}&lt;/pattern&gt;            &lt;charset&gt;utf8&lt;/charset&gt;        &lt;/encoder&gt;    &lt;/appender&gt;    &lt;root level=&quot;INFO&quot;&gt;        &lt;appender-ref ref=&quot;CONSOLE&quot; /&gt;        &lt;appender-ref ref=&quot;APPLICATION&quot; /&gt;    &lt;/root&gt;&lt;/configuration&gt;</code></pre><p>这里我选择使用 Interceptor 来放入MDC，给 Session 信息补偿和权限判定预留空间：</p><p><strong>MdcInterceptor.java</strong></p><pre><code class="java">@Componentpublic class MdcInterceptor implements HandlerInterceptor {    @Override    public boolean preHandle(HttpServletRequest request, HttpServletResponse response, Object handler)        throws Exception {        MDC.put(AppContext.KEY_TRACE_ID, AppContext.getContext().getTraceId());        return true;    }    @Override    public void postHandle(HttpServletRequest request, HttpServletResponse response, Object handler,        ModelAndView modelAndView) throws Exception {    }    @Override    public void afterCompletion(HttpServletRequest request, HttpServletResponse response, Object handler, Exception ex)        throws Exception {    }}</code></pre><p>在 Configuration 中注册 Interceptor:</p><p><strong>AppConfiguration.java</strong></p><pre><code class="java">@Configurationpublic class AppConfiguration extends WebMvcConfigurerAdapter {    @Autowired    private MdcInterceptor mdcInterceptor;    @Override    public void addInterceptors(InterceptorRegistry registry) {        registry.addInterceptor(mdcInterceptor);    }}</code></pre><p>把日志中的 <code>[{}]</code> 移除，尝试请求 API，可以看到日志中已经可以出现 traceId了：</p><p><img src="/images/trace-id-fail-with-thread-pool.png" alt=""></p><h2 id="使用-AOP-在多线程日志中打印全局参数"><a href="#使用-AOP-在多线程日志中打印全局参数" class="headerlink" title="使用 AOP 在多线程日志中打印全局参数"></a>使用 AOP 在多线程日志中打印全局参数</h2><p>上一步中打印出来的 traceId 在线程池中再次丢失了，这是因为与第一个实现 Context 的方式类似，MDC 也是使用 thread local，无法跨线程传递，要解决这个问题可以使用一个切面，讲 TTL 中的全局参数补偿到 DMC 中：</p><p>定义一个注解：</p><p><strong>MdcCompensation.java</strong></p><pre><code class="java">@Documented@Target(ElementType.METHOD)@Retention(RetentionPolicy.RUNTIME)public @interface MdcCompensation {}</code></pre><p>将注解和包的位置添加到切面的切点：</p><p><strong>MdcAspect.java</strong></p><pre><code class="java">@Aspect@Componentpublic class MdcAspect {    @Pointcut(&quot;execution(* com.adu21.spring.boot.global.param.trace.repository..*.*(..))&quot;)    public void service() {}    @Before(value = &quot;service() &amp;&amp; @annotation(mdcCompensation)&quot;)    public void doBefore(MdcCompensation mdcCompensation) {        MDC.put(AppContext.KEY_TRACE_ID, AppContext.getContext().getTraceId());    }}</code></pre><p>使用切面，注意这个地方由于 Spring 基于动态代理生成代理类的方式让客户端调用代理类而达到织入的效果，因此使用注解的方法只有在被外部类调用的时候才会生效：</p><p><strong>UserRepository.java</strong></p><pre><code class="java">@MdcCompensationpublic User getUserById(Long userId) {    ...}</code></pre><p>再次运行，可以看到所有链路都能打印出 traceId 了：</p><p><img src="/images/trace-id-success-with-thread-pool.png" alt=""></p><h1 id="代码示例"><a href="#代码示例" class="headerlink" title="代码示例"></a>代码示例</h1><p>文中使用的代码，完整版在这里：<a href="https://github.com/ADU-21/global-param-trace" target="_blank" rel="noopener">https://github.com/ADU-21/global-param-trace</a></p><h1 id="Reference"><a href="#Reference" class="headerlink" title="Reference"></a>Reference</h1><blockquote><ul><li><a href="https://blog.csdn.net/xuemengrui12/article/details/98783715" target="_blank" rel="noopener">https://blog.csdn.net/xuemengrui12/article/details/98783715</a></li><li><a href="https://github.com/alibaba/transmittable-thread-local" target="_blank" rel="noopener">https://github.com/alibaba/transmittable-thread-local</a></li><li><a href="https://blog.csdn.net/sunzhenhua0608/article/details/29175283" target="_blank" rel="noopener">https://blog.csdn.net/sunzhenhua0608/article/details/29175283</a></li><li><a href="https://www.jianshu.com/p/6534945eb3b5" target="_blank" rel="noopener">https://www.jianshu.com/p/6534945eb3b5</a></li></ul></blockquote>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;本文介绍如何基于 spring boot 获取、传递、使用一次会话的全局参数，并在所有链路日志中打印。&lt;/p&gt;
    
    </summary>
    
      <category term="Java" scheme="https://www.duyidong.com/categories/Java/"/>
    
    
      <category term="Springboot" scheme="https://www.duyidong.com/tags/Springboot/"/>
    
      <category term="微服务" scheme="https://www.duyidong.com/tags/%E5%BE%AE%E6%9C%8D%E5%8A%A1/"/>
    
      <category term="DMC" scheme="https://www.duyidong.com/tags/DMC/"/>
    
      <category term="全链路追踪" scheme="https://www.duyidong.com/tags/%E5%85%A8%E9%93%BE%E8%B7%AF%E8%BF%BD%E8%B8%AA/"/>
    
  </entry>
  
  <entry>
    <title>使用 Arthas 分析接口响应时间</title>
    <link href="https://www.duyidong.com/2019/11/26/arthas-analytics-rt/"/>
    <id>https://www.duyidong.com/2019/11/26/arthas-analytics-rt/</id>
    <published>2019-11-27T05:05:48.000Z</published>
    <updated>2020-01-08T13:18:47.252Z</updated>
    
    <content type="html"><![CDATA[<p>Arthas 是阿里巴巴开源的 Java 诊断工具，本文介绍如何使用 Arthas 分析 Java 应用的接口响应时间。</p><a id="more"></a><h1 id="分析接口响应时间"><a href="#分析接口响应时间" class="headerlink" title="分析接口响应时间"></a>分析接口响应时间</h1><p>在日常开发中，当我们发现应用的某个接口响应比较慢，这个时候想想要分析一下原因，找到代码中耗时的部分，比较容易想到的是在接口链路的 IO 操作上下游打印时间日志，再根据几个时间点的日志算出耗时长的 IO 操作。</p><p>这种方式没有问题，但是加日志需要发布，既繁琐又低效，这个时候可以引入一些线上 debug  的工具，arthas 就是很好的一种，除了分析耗时，还可以打印调用栈、方法入参及返回，类加载情况，线程池状态，系统参数等等，其实现原理是解析 JVM 在操作系统中的文件，大部分操作是只读的，对服务进程没有侵入性，因此可以放心使用。</p><p>本文以一个 Spring boot 应用为例，分析一个接口的耗时情况。</p><ul><li>启动应用</li></ul><pre><code class="bash">  git clone https://github.com/ADU-21/hello_springboot  cd hello_springboot  ./gradlew bootRun  curl 127.0.0.1:8080/sayHello    # 得到返回说明启动成功</code></pre><ul><li>启动 Arthas</li></ul><pre><code class="bash">  curl -O https://alibaba.github.io/arthas/arthas-boot.jar  java -jar arthas-boot.jar</code></pre><p>  在随后出现的列表中，选择<code>com.example.demo.DemoApplication</code>，这是 Spring boot 启动的进程。看到 arthas 的 loga 说明 attach 成功。</p><p>  <img src="/images/arthas-start.png" alt=""></p><ul><li><p>找到待分析的类，并打印方法调用时间。</p><p>分析接口调用时间，其实就是分析 Controller 类的方法调用时间，使用 <code>sc</code> 命令可以帮助找到待分析的类完整的路径和名称，<code>trace</code> 命令可以分析调用时间，还可以使用 <code>watch</code>命令实时获取方法调用参数和返回参数。</p></li></ul><pre><code class="bash">  sc *Controller    trace com.example.demo.controller.MyController sayHello</code></pre><p>  再次请求 <code>sayHello</code> 接口，就能看到实时的接口调用耗时情况：</p><p>  <img src="/images/arthas-running.png" alt=""></p><p>  从调用栈和时间中可以轻易找到耗时较长的调用。</p><h1 id="线上-Debug"><a href="#线上-Debug" class="headerlink" title="线上 Debug"></a>线上 Debug</h1><p>当你发现某个线上问题却没有日志追踪时可以尝试使用这种方式事实查看方法的入参和出参。</p><ul><li>使用 <a href="https://alibaba.github.io/arthas/watch.html" target="_blank" rel="noopener">watch</a> 命令可以打印出接口实时传入和返回的数据：</li></ul><pre><code class="bash">  watch com.example.demo.controller.MyController sayHello &quot;{params,target,returnObj}&quot; -x 2</code></pre><p>  <code>-x</code> 表示遍历的深度，<code>&quot;{params,target,returnObj}&quot;</code> 表示打印的内容，除此之外还可以根据耗时、是否抛出异常进行过滤，执行效果如图：</p><p>  <img src="/images/arthas-watch.png" alt=""></p><h1 id="小结"><a href="#小结" class="headerlink" title="小结"></a>小结</h1><p><a href="https://alibaba.github.io/arthas/arthas-tutorials?language=cn" target="_blank" rel="noopener">这里</a>有一个官方提供的 Arthas 学习体验教程，提供了一个虚拟的环境用于感受 Arthas 的各种功能，简单好用，推荐一试。</p><h1 id="References"><a href="#References" class="headerlink" title="References"></a>References</h1><blockquote><ul><li><a href="https://alibaba.github.io/arthas/" target="_blank" rel="noopener">https://alibaba.github.io/arthas/</a></li></ul></blockquote>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;Arthas 是阿里巴巴开源的 Java 诊断工具，本文介绍如何使用 Arthas 分析 Java 应用的接口响应时间。&lt;/p&gt;
    
    </summary>
    
      <category term="工具" scheme="https://www.duyidong.com/categories/%E5%B7%A5%E5%85%B7/"/>
    
    
      <category term="工具" scheme="https://www.duyidong.com/tags/%E5%B7%A5%E5%85%B7/"/>
    
      <category term="JVM" scheme="https://www.duyidong.com/tags/JVM/"/>
    
      <category term="分析" scheme="https://www.duyidong.com/tags/%E5%88%86%E6%9E%90/"/>
    
  </entry>
  
  <entry>
    <title>Bash 学习小计（二）</title>
    <link href="https://www.duyidong.com/2019/10/11/bash-study-2/"/>
    <id>https://www.duyidong.com/2019/10/11/bash-study-2/</id>
    <published>2019-10-12T00:40:09.000Z</published>
    <updated>2019-12-28T09:44:06.658Z</updated>
    
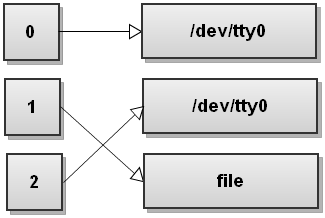
    <content type="html"><![CDATA[<p>很多看似复杂的系统背后实现其实真的很复杂，是因为它过多地使用了胶水语言和指令语言承载业务逻辑。这篇文章记录的是最近在使用 shell 时候学习到的一些小技巧和我认为适用与一定业务场景的比较好的实践。</p><a id="more"></a><h1 id="字符串处理"><a href="#字符串处理" class="headerlink" title="字符串处理"></a>字符串处理</h1><p>Shell 有很多命令语句如 <code>awk</code>，<code>sed</code> 都可以做字符串各种操作，其实 Shell 还内置有一系列操作符号，可以达到类似效果，使用内部操作符会省略启动外部程序等时间，因此速度会非常的快。</p><p>举个例子，要把用户输入的一段带路径的文件名把文件路径和文件名分离开来可以使用如下操作符：</p><pre><code class="bash">FILE_PATH=AAA/BBB/target/demo.jar${FILE_PATH%/*}  # output: AAA/BBB/target/${FILE_PATH##*/} # output: mode.jar</code></pre><p>获取一个变量展开后的值：</p><pre><code class="bash">echo $PARAM_KEY=&quot;${!PARAM_KEY}&quot; &gt; file</code></pre><p>再例如，替换一个变量中指定的值：    </p><pre><code class="bash">TIMESTAMP=`date +%H:%M:%S`TARGET=&#39;now is ${TIMESTAMP}&#39;TARGET=${TARGET//\$\{TIMESTAMP\}/$TIMESTAMP}  # now is 21:05:57</code></pre><p>类似的语法可以用于截取、替换、连接、获取长度、获取位置，更详细的操作说明可以参考这篇博客：<a href="https://www.iteye.com/blog/justcoding-1963463" target="_blank" rel="noopener">https://www.iteye.com/blog/justcoding-1963463</a>。</p><h1 id="使用-Python-作为-Bash-命令"><a href="#使用-Python-作为-Bash-命令" class="headerlink" title="使用 Python 作为 Bash 命令"></a>使用 Python 作为 Bash 命令</h1><p>有时候想要在 Shell 中使用一些简单的命令碰巧是某个 Python 库提供的，这个时候可以考虑把 Python 代码作为一个 Bash 命令，只需要一个 Alias，当然还要求你的操作系统环境中装有对应版本的 Python，例如 url encode &amp; decode：</p><pre><code class="bash">alias urldecode=&#39;python -c &quot;import sys, urllib as ul; print ul.unquote_plus(sys.argv[1])&quot;&#39;alias urlencode=&#39;python -c &quot;import sys, urllib as ul; print ul.quote_plus(sys.argv[1])&quot;&#39;# 使用urlencode &quot;中文&quot;                 # %E4%B8%AD%E6%96%87urldecode &quot;%E4%B8%AD%E6%96%87&quot;  # 中文</code></pre><h1 id="文件标识符"><a href="#文件标识符" class="headerlink" title="文件标识符"></a>文件标识符</h1><p>Shell 输出重定向有几种管用用法，比如把 输出重定向到文件：<code>command &gt;file</code>，把错误输出重定向到标准输出：<code>command 2&gt;&amp;1</code>，但当两种命令连起来使用的时候容易误写为<code>command 2&gt;&amp;1 &gt;file</code> ，这种情况下错误输出并不会打印到文件而会一直占用标准输出打印到控制台，因为 Bash 是顺序执行的，<code>2&gt;&amp;1</code> 把 sterr 重定向到了 stout，<code>&gt;file</code> 又把 stout 重定向到了 file，可这个时候 sterr 还在 stout，如下图所示，</p><p><img src="/images/duplicate-stderr-stdout-stdout-file.png" alt=""></p><p>这种情况可能在导致后台进程无法按预期退出到后台，正确的写法应该是：</p><pre><code class="bash">command &gt;file 2&gt;&amp;1# 或者command &amp;&gt;file</code></pre><p>这里有篇文章对 Bash 文件表示符重定向做了详细的解释：<a href="http://kodango.com/bash-one-liners-explained-part-three" target="_blank" rel="noopener">http://kodango.com/bash-one-liners-explained-part-three</a>，同一个系列的文章翻译质量和内容都很扎实，推荐有时间的朋友读一读。</p><h1 id="逐行读取"><a href="#逐行读取" class="headerlink" title="逐行读取"></a>逐行读取</h1><p>对于标准输出逐行处理的需求，可以使用 <em>IFS</em>（Internal Field Seprator，内部域分隔符）按行读取，再使用 read 命令写入变量中处理，例如对于不同字符开头的日志上色：</p><pre><code class="bash">step_exec() {    $@ 2&gt;&amp;1 | while IFS= read -r line; do        if [[ ${line} = \+* ]]; then            echo -e &quot;\033[1;36m[`date +%H:%M:%S`] [执行命令] $line&quot;;        elif [[ ${line} = \[ERROR\]* ]]; then            echo -e &quot;\u001b[91m[`date +%H:%M:%S`] $line&quot;;        elif [[ ${line} = \[WARNING\]* ]]; then            echo -e &quot;\u001b[33m[`date +%H:%M:%S`] $line&quot;;        elif [[ ${line} = \[SUCCESS\]* ]]; then            echo -e &quot;\u001b[92m[`date +%H:%M:%S`] $line&quot;;        else            echo &quot;[`date +%H:%M:%S`] $line&quot;;        fi    done    return ${PIPESTATUS[0]}}export -f step_exec &gt;&gt;/dev/null</code></pre><p>除了日志处理还可以用 <code>$PIPESTATUS</code> 变量获取管道符中第一个管道内的退出码。</p><p><code>export -f</code> 是模仿 js 的写法，把一个方法归置到一个文件中，用 export + source 的方式被其他文件应用。</p><h1 id="请求重试"><a href="#请求重试" class="headerlink" title="请求重试"></a>请求重试</h1><p>对于 curl 命令请求充实的需求，有如下实现：</p><pre><code class="bash">retry_times=0while    curl --fail $URL    [[ $? != &#39;0&#39; ]] &amp;&amp; (( retry_times &lt; 3 ))do    echo RETRY... $retry_times    (( retry_times++ ));done</code></pre><p>首先 curl –fail 可以让 curl 在得到返回码非 200 的时候以 22 为退出码错误退出，这个时候可以把重试次数和退出码作为判断条件作为是否重试的标示。bash 没有 do-while 语法，示例中是一种用 while-do 达到 do-while 效果的写法。</p><p>另外 bash 中书数学运算推荐使用  <code>(())</code> ，双括号的语法比传统的 <code>expr</code> /<code>let</code>更简洁高效，且 shell 原生支持而不需要内置命令工具。</p><h1 id="条件判断语句"><a href="#条件判断语句" class="headerlink" title="条件判断语句"></a>条件判断语句</h1><p>bash 条件判断的坑集中在变量是否展开上，例如 ls 的文件名称是否带空格，条件表达式中的变量展开是否带有空格或者特殊字符等等，使用 <code>[[]]</code> 双括号可以有效地避免这种问题，所以任何情况下条件判断语句中都推荐优先使用双中括号。</p><p>另外一个很实用的判断文件中是否包含某字符串的写法：</p><pre><code class="bash">if grep -q &#39;Connection timed out\|The remote end hung up&#39; $WORK_SPACE/error; then    return 1 # 超时重试fi</code></pre><p>利用 <code>grep -q</code>没有找到匹配就非零退出的特性，不仅比 <code>$(grep ... ) != …</code>这种写法更优雅，还可以避免多个子进程带来的问题。</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;很多看似复杂的系统背后实现其实真的很复杂，是因为它过多地使用了胶水语言和指令语言承载业务逻辑。这篇文章记录的是最近在使用 shell 时候学习到的一些小技巧和我认为适用与一定业务场景的比较好的实践。&lt;/p&gt;
    
    </summary>
    
      <category term="工具" scheme="https://www.duyidong.com/categories/%E5%B7%A5%E5%85%B7/"/>
    
    
      <category term="学习" scheme="https://www.duyidong.com/tags/%E5%AD%A6%E4%B9%A0/"/>
    
      <category term="小计" scheme="https://www.duyidong.com/tags/%E5%B0%8F%E8%AE%A1/"/>
    
      <category term="Linux" scheme="https://www.duyidong.com/tags/Linux/"/>
    
      <category term="Shell" scheme="https://www.duyidong.com/tags/Shell/"/>
    
  </entry>
  
  <entry>
    <title>一三五年陈和阿里味</title>
    <link href="https://www.duyidong.com/2019/09/02/one-three-five-years-in-alibaba/"/>
    <id>https://www.duyidong.com/2019/09/02/one-three-five-years-in-alibaba/</id>
    <published>2019-09-03T05:08:29.000Z</published>
    <updated>2019-09-02T14:20:18.003Z</updated>
    
    <content type="html"><![CDATA[<p>一年接纳、三年融入、五年开始有了阿里味。</p><a id="more"></a><blockquote><p>“为什么加入阿里？”</p><p>这个问题，同一个人在不同的时期会有不同的答案。</p><p>因为贫穷，因为优秀的同事，这是我刚来时候的想法。</p><p>一年后，想法变成了“这是一份不来一定会后悔的体验”。</p><p>最近跟一位五年陈的同事聊天，眉宇之间竟然读出了“阿里让我成为了更好的自己”。</p></blockquote><p>百年阿里（阿里的新人培训）第一次听到关于阿里一三五年陈的介绍，当时并没有很多感触，只是听到一位在阿里单身13年的前辈的分享，既觉得她在阿里的经历激动人心，又为她个人的牺牲感到惋惜。来之前有听说过阿里的文化是洗脑的，从那一刻开始，我觉得洗脑更像是在强化自我选择和自我认同感。</p><h2 id="这家公司适合什么样的人"><a href="#这家公司适合什么样的人" class="headerlink" title="这家公司适合什么样的人"></a>这家公司适合什么样的人</h2><p>阿里是一家对新人不太友好的公司。它更希望招募来的员工是来解决问题的，而不是“在一套体系下按照既定规则做事”。你被分配的任务往往具有很大的不可知性，你需要自己定义问题是什么，然后找到解决方案，抛给你问题的人最终只关注你的结果。这对未经世事的毕业生来说其实不大友好，缺人带。这也可能是近年来应届生逐渐缩招的原因，阿里只适合极少数已经成长得比较成熟在大学就已经比较能够独当一面的学生，因为这里不太有章法、不太有体系化的东西，不太舒服，不太能让你过上想象中职场精英那样“井井有条”的生活。这里很适合一个想做一番事情的、技能已经比较纯熟，有比较能吃苦的人，也给了很多展现自己能力的机会，而且是全方位的能力，你需要和人沟通，做设计、理需求，然后找到资源，把事情做成，一旦做成了一件事，就真的会很有成就感。这也是阿里和其他公司不太一样的地方，你会惊讶于怎么会有这样的公司，对员工这么不友好，也不太关注员工的成长，做事不讲方法不讲套路；这些可能是阿里的特点，也这家公司的魅力所在，像一家创业公司，给你平台、给你资源、做成什么样完全要靠你自己，最关键的是，等你做成之后公司会以相对公平的方式给你分享结果带来的利润。</p><h2 id="什么样的人做什么样的事"><a href="#什么样的人做什么样的事" class="headerlink" title="什么样的人做什么样的事"></a>什么样的人做什么样的事</h2><p>阿里是一家非常依赖人的公司。最直接的可以在应用维护上体现出来，一个应用的需求几乎主要是开始那个人在接，短时间看这是最省时间最高效的方法，长期就会造成这个应用的代码只有他一个人敢改，每次改别人的代码都会很痛苦。正因为如此，一个应用的 Owner 离开，这个应用大概率就得被重写。在阿里如果一个应用的时间超过三年就被认为是一个比较老的应用了。一些应用之所以维护到现在，也是因为 Owner 还没有离职而且他还愿意接需求。从 ThoughtWorks 过来的人一定很不能理解因为这就是我们批评的反模式，代码一定要随业务变动，团队一定要随时为成员的轮岗做好准备。但从另一个角度解释这个现象，这可能是阿里的文化带来的负面的作用。他既然存在即是有他的原因的，也是合理的。他可能不太符合我们的“最佳实践”，但他是阿里的特质，是这个电商帝国发展到现在内部达成的一种平衡。从“平凡人做平凡事”，到”非凡人做非凡事”，公司似乎也意识到人的重要性，意识到自己对人的依赖。通常我们会觉得这是不对的，公司不应该太依赖员工，公司和员工的关系应该是流水的和尚铁打的庙，但阿里不这么认为，因为阿里有一种自信，对自己文化的自信，相信星星之火可以在一批又一批离职又入职额员工之间传递下去，事实上阿里一年大概10%的换血频率是很稳的，也能保证文化不被稀释又恰好能吸收一些新鲜的血液进来。</p><blockquote><p>“这么一家公司，技术能力也不怎么样，业务能力也不是很强，也招不到很优秀的人，却能做成行业第二，你知道这是为什么吗？”</p><p>“不知道。”</p><p>“这就是我们要学习的地方。”  </p><p style="text-align:right">—— 来自一位饿么了的同事</p>                                                              </blockquote><h2 id="所谓-KPI"><a href="#所谓-KPI" class="headerlink" title="所谓 KPI"></a>所谓 KPI</h2><p>阿里是一家商业驱动的公司。20年来屹立于电商之巅从未被超越。有人说阿里的运营为王，不无道理，至少目前来看技术也还不是阿里的核心竞争力，在阿里的业务团队不太能感觉得到技术卓越，除了一些中间件和少部分专门投入在技术影响力上的团队，大部分团队的工作还是在码业务：在责任感、金钱、利益不管是什么驱动下，快速得用代码实现一些业务逻辑，既不会太接触到底层的东西，也没有太多技术上的创新。你的代码写成什么样，可能从你的主管开始就不是特别关心了。我的主管常说一句话“阿里是一家拿结果的公司”，这个结果很多时候是业务上的，就是你为公司拉了多少用户，为公司带来多少利润。所以阿里是家非常简单的公司，从不掩饰自己对市场的野心，这种野心是自上而下一致的，团队里每一个人都很清楚自己的目标，这个目标就是老板的目标。习惯性的站在老板的视角考虑，可能也是阿里做事方法对员工带来的比较正面的影响。</p><h2 id="为过程鼓掌，为结果付薪"><a href="#为过程鼓掌，为结果付薪" class="headerlink" title="为过程鼓掌，为结果付薪"></a>为过程鼓掌，为结果付薪</h2><p>阿里是一家很苦的公司，苦到不太有自己的生活。你可能爬出一个坑又掉进了另一个坑，这个别人都不太能接受的坑在你看来已经比上一个坑好太多了。在阿里的时间长了你会觉得晚上九点下班很好了，你会觉得 on call 半夜被电话起来紧急处理事情应该的因为你时常也有这样需要别人的时候，你会很优秀但依然是单身，别人看你会觉得好惨而你并不自知。因为努力是这个社会最普世的毒品，打了一针还想接着打。进步带来的快感可以暂时让你忘记这个社会认可的其他价值，娶妻生子的“完美”，或是吃喝玩乐”享受“。的这家公司的文化告诉你要去追逐你想要的，要商业成功，要加班，要多挣钱，他鼓励这些价值取向，跟国内大部分的人的想法是比较一致的，一个很简单的道理，要想成为人上人，必须要付出常人之所不能，所以在阿里不管是哪个 BU，工作强度都是很大的，有非官方统计表明，阿里的程序员平均每天的工作时间在 12 个小时。这样的工作强度让很多人只能有相当有限的时间陪伴自己的家庭。阿里是需要一些献身精神的，我以前对这种文化不认可且不理解，总觉得“有什么事是非那么急不可的？”，“个人时间神圣不可侵犯”，现在的我开始理解了这种价值观，即便在那样一个充满机遇的年代，也是要有超出常人的付出才能换来行业第一的回报的。一切就看你有没有这个野心和有没有这个决心。</p><p>对个人而言这就是你的选择，无数人的选择构成了这家公司的特质。</p><h2 id="到底什么是阿里味"><a href="#到底什么是阿里味" class="headerlink" title="到底什么是阿里味"></a>到底什么是阿里味</h2><p>回到开始的问题，为什么来阿里？其实阿里只是给了你这个选择，选择这样的人生，留下来，和一群有情有义的人一起做一件有意义的事。是否有意义需要你自己去判断，但很多时候只需要相信就够了，价值观就是要一遍一遍地告诉你，你的选择是对的，你在成为“更好的自己”。其实文化有时候很像宗教，无法被证明、无法被推翻，你可以选择信或者不信，如果你选择留在这个围城，选择相信会让你活得更轻松一些。你可能会质疑，会不服气，认为阿里是成长的既不充分也不必要条件，如何定义“更好的自己”完全是因人而异，但是没关系，毕竟还有年终奖兜底。</p><p>除了有钱，阿里确实是一家有情有义的公司。听说阿里的人跳槽到腾讯，过段时间看他朋友圈会发现“这不就是原来你们团队那帮人吗？”一方面反映出同事之间是比较团结互助的，就像是一家公司里来了一个印度人，接下来这家公司就会来很多印度人；另一方面反映出阿里人之间是互相的认可，这种认可就是文化，就是熟悉彼此身上那种味道，这种味道，就是阿里味。</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;一年接纳、三年融入、五年开始有了阿里味。&lt;/p&gt;
    
    </summary>
    
      <category term="阿里巴巴" scheme="https://www.duyidong.com/categories/%E9%98%BF%E9%87%8C%E5%B7%B4%E5%B7%B4/"/>
    
    
      <category term="小计" scheme="https://www.duyidong.com/tags/%E5%B0%8F%E8%AE%A1/"/>
    
      <category term="阿里巴巴" scheme="https://www.duyidong.com/tags/%E9%98%BF%E9%87%8C%E5%B7%B4%E5%B7%B4/"/>
    
  </entry>
  
  <entry>
    <title>在 Filter 中给 HttpServletRequest 添加 Header</title>
    <link href="https://www.duyidong.com/2019/08/18/add-custom-header-via-spring-filter/"/>
    <id>https://www.duyidong.com/2019/08/18/add-custom-header-via-spring-filter/</id>
    <published>2019-08-19T00:55:54.000Z</published>
    <updated>2019-12-29T04:51:49.580Z</updated>
    
    <content type="html"><![CDATA[<p>本文介绍如何在 Spring 的 Filter 中修改向下传递的 Request 中的 Header。</p><a id="more"></a><h1 id="业务场景"><a href="#业务场景" class="headerlink" title="业务场景"></a>业务场景</h1><p>系统已经有了一套基于 HTTP Header 的鉴权逻辑，现在我们希望在这套逻辑之上做一层扩展用于支持更多的鉴权类型，因此需要在 Interceptor 只上添加一个 Filter 把不同鉴权逻辑的信息转换为原有鉴权逻辑所需要的 Header。</p><h1 id="遇到问题"><a href="#遇到问题" class="headerlink" title="遇到问题"></a>遇到问题</h1><p>Filter 中能够获取到的 <a href="https://docs.oracle.com/javaee/6/api/javax/servlet/http/HttpServletRequest.html" target="_blank" rel="noopener">javax.servlet.http.HttpServletRequest</a> 暴露的接口，除了从其父接口 <a href="https://docs.oracle.com/javaee/6/api/javax/servlet/ServletRequest.html" target="_blank" rel="noopener">javax.servlet.ServletRequest </a> 接口继承的<code>setCharacterEncoding</code>方法和<code>setAttribute</code>方法之外，没有<code>setter</code>方法。因此 HttpServletRequest类型对象是只读的。</p><p>我们只能使用装饰器模式，扩展 HttpServletRequest 的一个实现类 <a href="https://docs.oracle.com/javaee/6/api/javax/servlet/http/HttpServletRequestWrapper.html" target="_blank" rel="noopener">javax.servlet.http.HttpServletRequestWrapper</a>，并使用装饰的对象<code>MutableHttpServletRequest</code>代替原始对象，以下为示例代码：</p><pre><code class="java">import java.util.Collections;import java.util.Enumeration;import java.util.HashMap;import java.util.HashSet;import java.util.Map;import java.util.Set;import javax.servlet.http.HttpServletRequest;import javax.servlet.http.HttpServletRequestWrapper;final class MutableHttpServletRequest extends HttpServletRequestWrapper {    // holds custom header and value mapping    private final Map&lt;String, String&gt; customHeaders;    public MutableHttpServletRequest(HttpServletRequest request){        super(request);        this.customHeaders = new HashMap&lt;String, String&gt;();    }    public void putHeader(String name, String value){        this.customHeaders.put(name, value);    }    public String getHeader(String name) {        // check the custom headers first        String headerValue = customHeaders.get(name);        if (headerValue != null){            return headerValue;        }        // else return from into the original wrapped object        return ((HttpServletRequest) getRequest()).getHeader(name);    }    public Enumeration&lt;String&gt; getHeaderNames() {        // create a set of the custom header names        Set&lt;String&gt; set = new HashSet&lt;String&gt;(customHeaders.keySet());        // now add the headers from the wrapped request object        @SuppressWarnings(&quot;unchecked&quot;)        Enumeration&lt;String&gt; e = ((HttpServletRequest) getRequest()).getHeaderNames();        while (e.hasMoreElements()) {            // add the names of the request headers into the list            String n = e.nextElement();            set.add(n);        }        // create an enumeration from the set and return        return Collections.enumeration(set);    }}</code></pre><p>有了这个装饰对象，就可以在 Filter 中使用 MutableHttpServletRequest 类来拦截传入的HTTP 请求以添加一些自定义 Header，代码如下：</p><pre><code class="java">import java.io.IOException;import javax.servlet.FilterChain;import javax.servlet.FilterConfig;import javax.servlet.ServletException;import javax.servlet.ServletRequest;import javax.servlet.ServletResponse;import javax.servlet.http.HttpServletRequest;import javax.servlet.http.HttpServletResponse;public class SecurityFilter implements javax.servlet.Filter {    @Override    public void destroy() {    }    @Override    public void doFilter(ServletRequest request, ServletResponse response,            FilterChain chain) throws IOException, ServletException {        HttpServletRequest req = (HttpServletRequest) request;        MutableHttpServletRequest mutableRequest = new MutableHttpServletRequest(req);        ...        mutableRequest.putHeader(&quot;x-custom-header&quot;, &quot;custom value&quot;);        chain.doFilter(mutableRequest, response);    }    @Override    public void init(FilterConfig filterConfig) throws ServletException {    }}</code></pre><h1 id="Reference"><a href="#Reference" class="headerlink" title="Reference"></a>Reference</h1><blockquote><ul><li><a href="https://wilddiary.com/adding-custom-headers-java-httpservletrequest/" target="_blank" rel="noopener">https://wilddiary.com/adding-custom-headers-java-httpservletrequest/</a></li></ul></blockquote>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;本文介绍如何在 Spring 的 Filter 中修改向下传递的 Request 中的 Header。&lt;/p&gt;
    
    </summary>
    
      <category term="Java" scheme="https://www.duyidong.com/categories/Java/"/>
    
    
      <category term="Springboot" scheme="https://www.duyidong.com/tags/Springboot/"/>
    
      <category term="微服务" scheme="https://www.duyidong.com/tags/%E5%BE%AE%E6%9C%8D%E5%8A%A1/"/>
    
      <category term="Servelet" scheme="https://www.duyidong.com/tags/Servelet/"/>
    
  </entry>
  
  <entry>
    <title>蜘蛛侠电影和这个越来越轻的社会</title>
    <link href="https://www.duyidong.com/2019/07/01/spider-man-with-the-society/"/>
    <id>https://www.duyidong.com/2019/07/01/spider-man-with-the-society/</id>
    <published>2019-07-01T08:14:15.000Z</published>
    <updated>2019-06-30T23:24:38.153Z</updated>
    
    <content type="html"><![CDATA[<p>从蜘蛛侠系列电影说起。</p><p>昨晚看了<em>蜘蛛侠：英雄远征</em>，保持着和上一部<em>平行世界</em>相当的水准，这在逢二必败的好莱坞工业体系中可以说是很难得的，纵观蜘蛛侠系列电影，这里我只说我有印象的五部，可以发现漫威系列的超级英雄电影正在逐渐变得越来越轻快，这似乎也符合这几十年来人类社会的发展轨迹。</p><p>19世纪末20世纪初，也就是1993年到2004年这段时间，出现了很多优秀的电影作品，都是苦大仇深的，诸如<em>泰坦尼克号</em>、<em>肖生克的救赎</em>、<em>霸王别姬</em>、<em>阿甘正传</em>，都是以一个人的一生映射一个时代，或是一代人的伤痕。可以溯源到19世纪人类经历的种种浩劫和世界格局的变化，19世纪人类经历了战争、独立、社会体制的探索、科技的飞跃、经济的高速发展、从生物尺度上来说几乎是爆照似地变化，人们开始在意时间，生活节奏开始加速，世界开始变小，几个大的社会经历了各种不同根因的动荡……总之这一个世纪发生了很多事情，站在千禧年的尾巴上，人们开始想要抛却旧的不好的东西同时展望新的生活，艺术开始回头，反思这一个世纪以来发生在人类社会的荒谬的事情，祭奠那些我们尊重的灵魂。于是成为了我们看到的激动人心的、深刻意义的电影。蜘蛛侠一、二部都是在这个时候诞生的，众多的超级英雄，也是在这个时期背负着他们的苦难，开始从废墟中站立起来，成为寄托着人们美好期望的英雄形象，想想<em>美国队长</em>和越战、<em>蝙蝠侠</em>和911、<em>X战警</em>和二战，是这个时代的分界点造就了漫威的这一批英雄。</p><p>大概是在 2006-2014这段时间，我看了蜘蛛侠的中间几部，这时期的电影充斥着对科技的迷恋，从蜘蛛侠与外星生物的结合到各种机械臂，高科技装备，超有钱的科学家钢铁侠，黑镜里各种科技的脑洞。这个时代的人们没有辜负上个世纪人们的期许，第四次技术革命造就了一个新的世纪，智能手机、互联网、人们对科技的想象从生活中渗透到了大荧幕上，这一时期也出现了很多优秀的科幻作品，<em>盗梦空间</em>、<em>星际穿越</em>、<em>源代码</em>，人们寄想象于科技，加上从战争中释放出来的大批生产力以及相对稳定的世界格局，人类社会开始乘着科技的风帆大踏步前进。</p><p>尽管这一时期基础科学没有多大进展，学术成绩寥寥。</p><p>最近两部蜘蛛侠电影，平行世界和英雄归来，换了更年轻的演员，更简单的剧情，以及更幽默的方式，一改最早的蜘蛛侠系列的电影，英雄的痛苦与爱恨情仇不在，有的只是高中生似的单纯和诙谐。毫无疑问这是这一代观影群体的特征写照，似乎千禧年后出生的人都是这样轻松，没有了痛苦的记忆。</p><p>我们似乎创造了一个更好的社会，而且在往越来越好的方向发展。但我们似乎也失去了对这个世界的好奇，只有在学术顶端的科学家们时刻还能意识到我们的世界观是由大部分未知和极少部分暂时未被推翻的理论支撑起来的。我们过于自信地以为我们的逻辑可以推理、证明一切，我们误以为存在一种社会制度能够保证所有人的权利和责任的对等，我们认为大国之间靠核威慑就可以存在永久的和平。大家平时忙着挣钱，没人关心人类，没人关心自己日渐憔悴的内心。</p><p>我们相信真理和绝对正义的存在，技术成为了最大的宗教，经济问题成为了唯一的问题。人类的世界正在变得越来越小，甚至有点无聊。</p><p>我们活在一个娱乐至死的时代，这似乎没有什么不好，但我还是想提醒自己，不要停止怀疑这个世界，要像上个时代的诗人一样保持提问的能力，提问并不可怕，可怕的是你回答了自己所有的问题。提问是一个文明存在的最好证明，是走出黑域的最短途径。</p>]]></content>
    
    <summary type="html">


        &lt;p&gt;从蜘蛛侠系列电影说起。&lt;/p&gt;
&lt;p&gt;昨晚看了&lt;em&gt;蜘蛛侠：英雄远征&lt;/em&gt;，保持着和上一部&lt;em&gt;平行世界&lt;/em&gt;相当的水准，这在逢二必败的好莱坞工业体系中可以说是很难得的，纵观蜘蛛侠系列电影，这里我只说我有印象的五部，可以发现漫威系列的超级英雄电影正在逐渐变得越来
      
    
    </summary>
    
      <category term="我的博客" scheme="https://www.duyidong.com/categories/%E6%88%91%E7%9A%84%E5%8D%9A%E5%AE%A2/"/>
    
    
      <category term="闲言碎语" scheme="https://www.duyidong.com/tags/%E9%97%B2%E8%A8%80%E7%A2%8E%E8%AF%AD/"/>
    
  </entry>
  
  <entry>
    <title>下一代镜像构建工具 Buildkit</title>
    <link href="https://www.duyidong.com/2019/05/19/build-image-in-container-via-buildkit/"/>
    <id>https://www.duyidong.com/2019/05/19/build-image-in-container-via-buildkit/</id>
    <published>2019-05-19T17:39:07.000Z</published>
    <updated>2019-05-19T04:23:42.301Z</updated>
    
    <content type="html"><![CDATA[<p>Buildkit 是 Docker 公司出品的一款更高效、docekrfile 无关、更契合“<a href="https://www.duyidong.com/2017/05/03/Cloud-Native/">云原生应用</a>” 的新一代 Docker 构建工具。</p><h1 id="开源工具已经不能满足-DID-的需求"><a href="#开源工具已经不能满足-DID-的需求" class="headerlink" title="开源工具已经不能满足 DID 的需求"></a>开源工具已经不能满足 DID 的需求</h1><p>云原生的一个特点是一切基础设施都是动态的，除了提供服务的基础设施，CICD 的计算资源也趋向动态创建。很多企业已经有了自己的 k8s 集群作为服务，自然而然开始思考如何把 CICD 搬到 k8s 中，各种 CI 工具的插件应运而生，而容器集群中的构建成为了各种工具的焦点问题。</p><h2 id="DID-Docker-in-docker-的演进"><a href="#DID-Docker-in-docker-的演进" class="headerlink" title="DID (Docker in docker 的演进)"></a>DID (Docker in docker 的演进)</h2><p>最原始的 Docker in docker 是使用 privilege 将宿主机的一切权限共享给用于构建的容器实例，这种方式容器可以获得宿主机的最高权限，有很大风险，很快就被淘汰了。</p><p>目前比较普遍的做法，是把 Docker daemon 的 socket 挂在到用于构建的容器中:</p><pre><code class="bash">docker run -v /var/run/docker.sock:/var/run/docker.sock -it docker</code></pre><p>这种方式已经经历了较长时间的验证，可以满足企业内部使用的大部分场景：</p><ul><li><strong>远程仓库权限：</strong>对于 Docker credential 的隔离可以利用不同容器实例之间 Home directory 不同做到</li><li><strong>缓存：</strong>同一台宿主机上的缓存可以通过同一个 Docker daemon 共享</li><li><strong>本地权限：</strong>由于不同容器实例挂在同一个宿主机的 Docker daemon 进程，所有实例里 docker 命令的权限也是共享的，也就是说不同容器实例可以查看甚至更新、删除到同一个 Docker daemon 下别的容器实例构建产生的镜像。</li></ul><p>本地权限的问题如果是在一个小企业内部以共享账号的方式或许还可以接受，稍微大一点的企业可以通过限制用户输入 Docker 命令，防止注入来规避权限盗用的风险。但目前看来这些方法都还是治标不治本，治本的方案要么是在 Docker daemon 建立一套权限机制，要么让 Docker 里的构建不依赖同一个 Docker daemon。</p><h1 id="Build-without-docker-daemon"><a href="#Build-without-docker-daemon" class="headerlink" title="Build without docker daemon"></a>Build without docker daemon</h1><p>社区中目前有三款工具可以支持无 docker daemon 化的构建： kaniko，img 和 buildkit.</p><ul><li><a href="https://github.com/GoogleContainerTools/kaniko" target="_blank" rel="noopener">Kaniko</a> 是由 Google 开发的在 k8s 上做 docker 构建的命令行工具，使用非常简洁，只需要 build 一个二进制工具即可，支持 dockerfile 构建、push、credentail 文件读取。</li><li><a href="https://github.com/moby/buildkit" target="_blank" rel="noopener">Buildkit</a> 是 docker 公司开发，目前由社区和 docker 公司合理维护的“含着金钥匙出生”的新一代构建工具，拥有良好的扩展性、极大地提高了构建速度，以及更好的安全性，功能上配合 docker 使用还是没问题的，独立使用功能其实有残缺，这个放到后面来讲。</li><li><a href="https://github.com/genuinetools/img" target="_blank" rel="noopener">img</a> 是社区贡献者开发，基于 buildkit 封装的类 docker 化命令行工具，无需 daemon 进程，无需 privilege，可以独立运行的二进制工具，非常小巧易用，而且有着和 buildkit 一样的性能优势。</li></ul><h2 id="社区活跃度"><a href="#社区活跃度" class="headerlink" title="社区活跃度"></a>社区活跃度</h2><p><strong>kaniko &gt; img &gt; buildkit</strong></p><p><img src="/images/kaniko-insights.png" alt=""></p><p><img src="/images/img-insigths.png" alt=""></p><p><img src="/images/buildkit-insights.png" alt=""></p><p>可以看出三个工具中 kaniko 是 star 最多的项目， img 目前是缺少维护的状态，buildkit start 最少但是社区活跃度还比较高。</p><h2 id="kaniko-踩坑"><a href="#kaniko-踩坑" class="headerlink" title="kaniko 踩坑"></a>kaniko 踩坑</h2><p>初步看来 kaniko 似乎是最佳选择，大厂背书，相对活跃的社区和相对多的市场验证。然而我们却发现了当前版本(v0.9.0)的两个不足：</p><ul><li>Dockerfile 支持不全：由于实现方式和 docker 不同，kaniko 并不是完全兼容 dockerfile 的所有语法：例如多阶段构建中 FROM … AS xxx 的语法 xxx 首字母不能大写；from 的镜像系统文件无法在 build 的时候被覆盖而是会报错</li><li>缓存不能共享，kaniko 的缓存只能够利用到基础镜像级别，即事先把镜像放到缓存目录下， kaniko 可以使用这个本地镜像，而构建过程中产生的镜像 layers 则不能复用。docker 多阶段构建会有相当多的 dependency 中间产物，每次构建都去下载这些依赖会极大地降低构建速度从而带来不好的体验</li></ul><p>基于以上两点，kaniko 似乎仍是一个不够成熟的工具，暂时不能投入生产。</p><h2 id="img-踩坑"><a href="#img-踩坑" class="headerlink" title="img 踩坑"></a>img 踩坑</h2><p>了解过 buildkit 的高性能之后，对 img 这样集简洁与性能于一身的工具可谓是满怀期待，而事实却不尽如人意，虽然 kaniko 遇到的 dockerfile  img 都轻松支持了，但是在多阶段镜像构建的时候似乎在并行构建的处理上有些问题，对于复杂的多阶段构建会频繁曝出 IO 异常，怀疑是缺少了 daemon 进程文件锁的功能导致的，只好放弃。</p><h1 id="Buildkit-介绍"><a href="#Buildkit-介绍" class="headerlink" title="Buildkit 介绍"></a>Buildkit 介绍</h1><p>最后来说说本文的主角：<a href="https://github.com/moby/buildkit" target="_blank" rel="noopener">buildkit</a></p><p>Buildkit 是由 Docker 公司开发的<strong>“下一代 docker build 工具”</strong>，2018 年 7 月正式内置于 Docker-ce 18.06.0 的 Docker daemon ，Mac 和 Linux 可以使用环境变量 <code>DOCKER_BUILDKIT=1</code> 开启，同年 10 月发布社区版本。 </p><p>相比于 Docker daemon build，buildkit：</p><ul><li>更<strong>高效</strong>：支持并行的多阶段构建、更好的缓存管理；</li><li>更<strong>安全：</strong>支持 secret mount，无需 root priviliege；</li><li>更<strong>易于扩展</strong>：使用自定义中间语言 LLB，完全兼容 Dockerfile，也可支持第三方语言（目前仅有<a href="https://github.com/tonistiigi/buildkit-pack" target="_blank" rel="noopener">Buildpacks</a>），后台目前可支持 runC 和 containerd 两种 worker。</li></ul><p>目前社区除了 moby/docker-ce 外还在使用 buildkit 的项目有 genuinetools/img, openFaaS Cloud, containerbuilding/cbi。</p><h2 id="与其他构建工具对比"><a href="#与其他构建工具对比" class="headerlink" title="与其他构建工具对比"></a>与其他构建工具对比</h2><p><img src="/images/compare-ioc-build.png" alt=""></p><p>需要补充的一点是 buildkit 是对 Dockerfile 语法完全支持：</p><p><img src="/images/buildkit-full-compatible-dockerfile.png" alt=""></p><center>图片来源：<a href="https://www.youtube.com/watch?v=kkpQ_UZn2uo" target="_blank" rel="noopener">https://www.youtube.com/watch?v=kkpQ_UZn2uo</a></center><h2 id="工作原理"><a href="#工作原理" class="headerlink" title="工作原理"></a>工作原理</h2><p><strong>buildkitd &amp; buildctl</strong></p><p>后台启动一个buildkitd 守护进程，通过 http 通信的方式执行构建。</p><ul><li><strong>gRPC API: </strong> 使用 Google RPC 协议高效通信</li><li><strong>Go client library：</strong> 基于 Go 的客户端方便调用</li><li><strong>rootless execution:</strong>  buildctl 不需要 root 权限就可以执行</li><li><strong>OpenTracing：</strong> 支持镜像 layer 的逐层溯源</li><li><strong>multi-worker model：</strong>支持多种 worker(runC 和 containerd)，可扩展</li></ul><h1 id="使用"><a href="#使用" class="headerlink" title="使用"></a>使用</h1><h2 id="安装"><a href="#安装" class="headerlink" title="安装"></a>安装</h2><p>官方镜像：<a href="https://hub.docker.com/r/moby/buildkit" target="_blank" rel="noopener">https://hub.docker.com/r/moby/buildkit</a></p><pre><code class="bash">docker run --name buildkit -d --privileged -p 1234:1234 moby/buildkit --addr tcp://0.0.0.0:1234export BUILDKIT_HOST=tcp://0.0.0.0:1234docker cp buildkit:/usr/bin/buildctl /usr/local/bin/buildctl build --help</code></pre><p>Mac OS 在 <a href="https://github.com/moby/buildkit/releases" target="_blank" rel="noopener">https://github.com/moby/buildkit/releases</a> 下载 buildctl</p><h2 id="构建"><a href="#构建" class="headerlink" title="构建"></a>构建</h2><pre><code class="bash"># 本地构建buildctl --addr tcp://localhost:1234 build --frontend=dockerfile.v0 --local context=. --local dockerfile=.# 等同于 docker buildbuildctl --addr tcp://localhost:1234 build --frontend=dockerfile.v0 --local context=. --local dockerfile=. --output type=docker,name=myimage | docker load# pushbuildctl build --frontend dockerfile.v0 --local context=. --local dockerfile=. --output type=image,name=docker.io/username/image,push=true</code></pre><h2 id="权限"><a href="#权限" class="headerlink" title="权限"></a>权限</h2><p>使用 docker credentials权限</p><p>可以使用环境变量 DOCKER_CONFIG 指定 credential 读取路径从而达到权限隔离（这方面缺少文档，可以参考源码）：</p><p><a href="https://github.com/moby/buildkit/blob/master/cmd/buildctl/build.go#L157" target="_blank" rel="noopener">https://github.com/moby/buildkit/blob/master/cmd/buildctl/build.go#L157</a></p><p><a href="https://github.com/docker/cli/blob/master/cli/config/config.go#L127" target="_blank" rel="noopener">https://github.com/docker/cli/blob/master/cli/config/config.go#L127</a></p><p><img src="/images/docker-config-credential.jpg" alt=""></p><h2 id="缓存"><a href="#缓存" class="headerlink" title="缓存"></a>缓存</h2><p>buildkit 支持 layer 级别缓存，可指定缓存 export/import 路径。</p><p>可以使用 registry 缓存：<a href="https://github.com/moby/buildkit#exportingimporting-build-cache-not-image-itself" target="_blank" rel="noopener">https://github.com/moby/buildkit#exportingimporting-build-cache-not-image-itself</a></p><h1 id="不足"><a href="#不足" class="headerlink" title="不足"></a>不足</h1><h2 id="运行权限"><a href="#运行权限" class="headerlink" title="运行权限"></a>运行权限</h2><p>Buildkitd 运行需要 privilege，这里有一个 <a href="https://github.com/moby/buildkit/issues/252" target="_blank" rel="noopener">issue</a> 解释说是因为 runC 读写宿主机文件系统需要 root 权限</p><h2 id="稳定性测试"><a href="#稳定性测试" class="headerlink" title="稳定性测试"></a>稳定性测试</h2><p>跑了一个晚上的定时脚本，构建的是同一个多阶段镜像，得到的结果不尽如人意：</p><ul><li><p>速度不太稳定，同一个镜像在没有网络依赖的情况下构建速度在 30s-10min 之间摆动</p><p><img src="/images/buildkit-time.png" alt=""></p></li><li><p>buildctl 和同一台宿主机上的 buildkitd 通信不时会出现网络问题，出现概率 10%</p><p><img src="/images/buildkit-error.png" alt=""></p></li></ul><h1 id="结论"><a href="#结论" class="headerlink" title="结论"></a>结论</h1><p>Buildkit 似乎是一个很有前景的产品，只是目前还没有达到生产环境需要的水平。</p><p>我比较看好它的设计，比如内置文件数据库，中心化调度思维，前后端可扩展，权限扩展单元，这些都是云原生时代需要的，只是产品的打磨还需要加以时日，以及市场的砺炼。</p><h1 id="Reference"><a href="#Reference" class="headerlink" title="Reference"></a>Reference</h1><p><a href="https://s3.amazonaws.com/duyidong-archive/pdf/containerdbuildkitbreakout-180628204303.pdf" target="_blank" rel="noopener">https://s3.amazonaws.com/duyidong-archive/pdf/containerdbuildkitbreakout-180628204303.pdf</a></p><p><a href="https://s3.amazonaws.com/duyidong-archive/pdf/Comparing-next-generation-container-image-building-tools.pdf" target="_blank" rel="noopener">https://s3.amazonaws.com/duyidong-archive/pdf/Comparing-next-generation-container-image-building-tools.pdf</a></p>]]></content>
    
    <summary type="html">


        &lt;p&gt;Buildkit 是 Docker 公司出品的一款更高效、docekrfile 无关、更契合“&lt;a href=&quot;https://www.duyidong.com/2017/05/03/Cloud-Native/&quot;&gt;云原生应用&lt;/a&gt;” 的新一代 Docker 构建工具。&lt;/
      
    
    </summary>
    
      <category term="工具" scheme="https://www.duyidong.com/categories/%E5%B7%A5%E5%85%B7/"/>
    
    
      <category term="工具" scheme="https://www.duyidong.com/tags/%E5%B7%A5%E5%85%B7/"/>
    
      <category term="容器" scheme="https://www.duyidong.com/tags/%E5%AE%B9%E5%99%A8/"/>
    
      <category term="docker" scheme="https://www.duyidong.com/tags/docker/"/>
    
  </entry>
  
  <entry>
    <title>Spring boot 注解</title>
    <link href="https://www.duyidong.com/2019/04/28/springboot-annotation/"/>
    <id>https://www.duyidong.com/2019/04/28/springboot-annotation/</id>
    <published>2019-04-29T01:07:07.000Z</published>
    <updated>2019-05-19T10:26:48.721Z</updated>
    
    <content type="html"><![CDATA[<p>Springboot 相比于 Spring 的强大之处在于用注解解决了很多 Spring 的设计中需要配置来解决的问题，极大地提高了开发体验。这篇文章主要解释 Springboot 是如何使用注解实现依赖注入的。</p><h2 id="Java-注解"><a href="#Java-注解" class="headerlink" title="Java 注解"></a>Java 注解</h2><p>在讲解 Springboot 注解之前先来看看 Java 的注解，每当你创建描述符性质的类或者接口时,一旦其中包含重复性的工作，就可以考虑使用注解来简化与自动化该过程。</p><p>Java 注解又称 Java 标注，是 Java 语言 5.0 版本开始支持加入源代码的特殊语法元数据。注解本身并不承载功能，而是绑定在 Java 成员上的一些元数据，可以在特定的时候（编译检查、运行）时被获取和处理。</p><p>Java 最开始提供了 4 种元注解，直到 jdk1.8 增加到 7 种，专门负责新注解的创建工作。</p><p><strong>元注解（作用在其他注解的注解）</strong></p><ul><li><code>@Target</code> - 标记这个注解应该是哪种 Java 成员。</li><li><code>@Retention</code> - 标识这个注解怎么保存，是只在代码中，还是编入class文件中，或者是在运行时可以通过反射访问。</li><li><code>@Documented</code> - 标记这些注解是否包含在用户文档中。</li><li><code>@Inherited</code> - 标记这个注解是继承于哪个注解类(默认 注解并没有继承于任何子类)</li><li><code>@SafeVarargs</code> - Java 7 开始支持，忽略任何使用参数为泛型变量的方法或构造函数调用产生的警告。</li><li><code>@FunctionalInterface</code> - Java 8 开始支持，标识一个匿名函数或函数式接口。</li><li><code>@Repeatable</code> - Java 8 开始支持，标识某注解可以在同一个声明上使用多次。</li></ul><p>我们来看一个最常见的注解<code>@Override</code>的源码：</p><pre><code class="java">@Retention(RetentionPolicy.RUNTIME)@Target(ElementType.METHOD)public @interface Before {}</code></pre><p><code>@interface</code> 是 Java 注解申明的关键字，它的元注解翻译过来就是“可以用于 Java 方法，并保留至运行时，且不出现在用户文档中”。</p><p>更多使用元注解自定义注解可以参考我写的一个小 demo: <a href="https://github.com/ADU-21/java-annotation" target="_blank" rel="noopener">https://github.com/ADU-21/java-annotation</a>，这里就不展开赘述了。</p><h1 id="Spring-boot-注解"><a href="#Spring-boot-注解" class="headerlink" title="Spring boot 注解"></a>Spring boot 注解</h1><p>相比于 Java，Springboot 为我们提供更多的注解，用于依赖注入的有·<code>@Autowired</code>、<code>@Resource</code>、<code>@Qualifier</code>、<code>@Service</code>、<code>@Controller</code>、<code>@Repository</code>、<code>@Component</code>。</p><p>上面有提到注解本身只是元数据而不实现功能。那 Springboot 从一个类被标记上注解到被注入到 Ioc 容器中都发生了什么？这就要从 Springboot 的启动流程说起。</p><h3 id="Springboot-启动流程"><a href="#Springboot-启动流程" class="headerlink" title="Springboot 启动流程"></a>Springboot 启动流程</h3><p>springboot 启动流程大图，可以参考：<a href="https://www.processon.com/view/link/59812124e4b0de2518b32b6e" target="_blank" rel="noopener">https://www.processon.com/view/link/59812124e4b0de2518b32b6e</a></p><p><strong>首先</strong>，很熟悉的是，SpringBoot为我们提供了一个注解，@SpringBootApplication, 打开注解的源码我们可以看到，主要由以下几个注解组成：</p><ul><li><p><strong>@SpringBootConfiguration</strong></p><p><code>@SpringBootConfiguration</code>注解是由<code>@Configuration</code>来注解的，因此也就表示Application类本身就是一个 Bean。虽然<code>@SpringBootConfiguration</code>注释中说该注解一个应用中只能用一次，但是配置多个也不会报错，只是建议在一个应用中只用一次，并且该注解也可以与<code>@Configuration</code>互换。</p></li><li><p><strong>@EnableAutoConfiguration</strong></p><p><code>@EnableAutoConfiguration</code>用于开启自动配置的。通过这个注解我们就能使用很多默认的配置来进行程序的开发，这个注解集成了<code>@EnableAutoConfiguration</code>注解，这个注解就是 auto-configuration 的核心，源码如下：</p><p><img src="/images/EnableAutoConfiguration.png" alt=""></p><p><strong>1</strong>.  其中最核心的就是<code>@Import(EnableAutoConfigurationImportSelector.class)</code>。 <code>@Import</code>注解的作用就是导入其他的配置。</p><p><strong>2</strong>.  在 Spring 容器启动的时候会利用<code>ConfigurationClassPostProcessor</code>进行解析，这个类实现了<code>BeanDefinitionRegistryPostProcessor</code>，在容器启动的时候会调用其方法对扫描路径下的<code>@Configuration</code>注解进行扫描和解析。</p><p><strong>3</strong>.  在解析<code>@Configuration</code>的时候会去解析<code>@Import</code>注解，其中<code>EnableAutoConfigurationImportSelector</code>类是<code>AutoConfigurationImportSelector</code>的子类，<code>AutoConfigurationImportSelector</code>中会进行当前根路径下的 jar 包下的 META-INF/spring.factories 文件的扫描和读取。并且将其中涉及到的 Bean 配合<code>@Conditional</code>注解添加到 Spring 容器中。</p><p>整体的调用链如下：</p><p><img src="/images/spring-auto-configuration.png" alt=""></p></li><li><p><strong>@ComponentScan</strong></p><p>这是Springboot 注入的重点，<code>@ComponentScan</code>注解的功能与 Spring 在 xml 文件配置的的功能是一样的，而上面也提到 Application 类放在源码的根目录下，其实就是与这个注解有关。<code>@ComponentScan</code>在没有指明basePackages 属性的时候，默认会扫描该注解所在的类的包及其子包下的所有<code>@Component</code>注解过的类，包括<code>@Controller</code>，<code>@Service</code>，<code>@Configuration</code>这些注解。这也就是为什么我们不用做任何配置，就可以将Springboot 应用中的类扫描为 Bean。</p><p>调用栈可以参考下图：</p><p><img src="/images/component-scan-stack.png" alt=""></p><p>具体实现的方法为：<code>ConfigurationClassParser.doProcessConfigurationClass</code>:</p><p><img src="/images/ConfigurationClassParser-doProcessConfigurationClass.png" alt=""></p></li></ul><h3 id="Spring-Bean-加载"><a href="#Spring-Bean-加载" class="headerlink" title="Spring Bean 加载"></a>Spring Bean 加载</h3><p>取到所有带 <code>@Component</code> 注解的类之后就是创建实例了，再来看调用栈：</p><p><img src="/images/springboot-newInstance.png" alt=""></p><p>对应前面大图里工厂模式一块：</p><p><img src="/images/spring-boot-start-map.png" alt=""></p><p>事实上 Springboot 源码中在 context refresh 里有包含了绝大多数我们关心的和 bean 有关的处理：</p><p><img src="/images/spring-context-refresh.png" alt=""></p><h2 id="Reference"><a href="#Reference" class="headerlink" title="Reference"></a>Reference</h2><p><a href="http://www.cnblogs.com/ITtangtang/p/3974531.html" target="_blank" rel="noopener">http://www.cnblogs.com/ITtangtang/p/3974531.html</a></p><p><a href="https://zh.wikipedia.org/wiki/Java%E6%B3%A8%E8%A7%A3" target="_blank" rel="noopener">https://zh.wikipedia.org/wiki/Java%E6%B3%A8%E8%A7%A3</a></p><p><a href="https://segmentfault.com/a/1190000012887776" target="_blank" rel="noopener">https://segmentfault.com/a/1190000012887776</a></p><p><a href="http://www.cnblogs.com/xrq730/p/6285358.html" target="_blank" rel="noopener">http://www.cnblogs.com/xrq730/p/6285358.html</a></p><p><a href="https://www.jianshu.com/p/414d3e2f04e9" target="_blank" rel="noopener">https://www.jianshu.com/p/414d3e2f04e9</a></p>]]></content>
    
    <summary type="html">


        &lt;p&gt;Springboot 相比于 Spring 的强大之处在于用注解解决了很多 Spring 的设计中需要配置来解决的问题，极大地提高了开发体验。这篇文章主要解释 Springboot 是如何使用注解实现依赖注入的。&lt;/p&gt;
&lt;h2 id=&quot;Java-注解&quot;&gt;&lt;a href=&quot;
      
    
    </summary>
    
      <category term="Java" scheme="https://www.duyidong.com/categories/Java/"/>
    
    
      <category term="Java" scheme="https://www.duyidong.com/tags/Java/"/>
    
      <category term="Spring" scheme="https://www.duyidong.com/tags/Spring/"/>
    
      <category term="Springboot" scheme="https://www.duyidong.com/tags/Springboot/"/>
    
  </entry>
  
  <entry>
    <title>新年伊始</title>
    <link href="https://www.duyidong.com/2019/02/09/end-of-2018-start-of-2019/"/>
    <id>https://www.duyidong.com/2019/02/09/end-of-2018-start-of-2019/</id>
    <published>2019-02-10T00:50:01.000Z</published>
    <updated>2019-02-24T14:58:08.415Z</updated>
    
    <content type="html"><![CDATA[<p>这是一篇姗姗来迟的年终总结。</p><a id="more"></a><p>2018 是忙碌的一年，印象中这一年没有过放松的周末。</p><p>2018 是偷懒的一年，这一年我写了 13 篇博客，其中并没有多少真知灼见。</p><p>2018 是变化的一年，生活上，工作上，出国，换工作。</p><h1 id="天空留不下鸟飞过的痕迹，而我已经飞过"><a href="#天空留不下鸟飞过的痕迹，而我已经飞过" class="headerlink" title="天空留不下鸟飞过的痕迹，而我已经飞过"></a>天空留不下鸟飞过的痕迹，而我已经飞过</h1><p>去年上半年认真看了下 Java 的基础知识，再接受第一次做 TL 的项目之前补了补英语，随后有了去澳洲的机会，回来之后做了 DDD 的 workshop，之后就跳槽到了阿里巴巴。</p><p>这一年做得比较好的是夯实了基础，在代码能力方面也有了实质性的进展，代码量也比前两年多了许多。</p><p>缺点和不足主要还是项目上的投入和产出都比较少，一方面是由于客观原因投入的时间不算多，另一方面因为受到时间的影响，反思总结得也不够。这一年学习的东西还是一些与项目关系不大的知识点，且这些学习除了自己知道得多了一点并没有拿到项目中使用和转化为真正的价值，这也让我的成就感大打折扣，可以说是下半年换工作的重要原因。</p><h1 id="仰望星空，脚踏实地"><a href="#仰望星空，脚踏实地" class="headerlink" title="仰望星空，脚踏实地"></a>仰望星空，脚踏实地</h1><p>因此在新的公司，新的工作岗位，希望我所学习、积累的知识能够围绕我们的产品，不论是竞品调用还是底层知识的学习，都围绕做好一个产品服务。</p><p>在研发效能的工作分为两个阶段，第一个阶段为总结现有工作模式，摸清现在的工作方式，常用工具，设计思想，对飙行业内其他工具如何，以及背后的实现原理，产出物为博客，视脱敏情况发表在阿里内网或这个博客上。现在想到的点比如说测试环境隔离，分支管理策略，都是可以学习摸索的点。而且有前辈可以一起讨论。</p><p>第二个阶段则是思考如何在现有工作模式基础上提高工作效率，这个提高效率一方面是提高自己的工作效率，一方面是提高团队的工作效率，如果能形成产品就更好了。</p><p>除了工作成为重点，有三个事情希望不要放下，一是学习英语，二是锻炼身体，三是看和工作无关的书。</p><h1 id="太阳尚远但必有太阳"><a href="#太阳尚远但必有太阳" class="headerlink" title="太阳尚远但必有太阳"></a>太阳尚远但必有太阳</h1><blockquote><p>作最坏的打算，尽最大的努力。</p></blockquote><p>今年的目标：</p><ul><li>拿到摩托车驾照，骑自己的摩托车去一趟千岛湖</li><li>坚持跑步 260 天</li><li>参加一次DevOps &amp; Cloud相关的全国大会</li><li>学习完 Acloud guru 上的全部课程</li><li>产出关于阿里巴巴研发效能的博客三篇，关于自己对于行业认知的博客两篇</li></ul><p>程序员之路至今已走了三年，期间有很多不如意，有很多幸运，不变的是努力，和不放过每一个机会。</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;这是一篇姗姗来迟的年终总结。&lt;/p&gt;
    
    </summary>
    
      <category term="学习总结" scheme="https://www.duyidong.com/categories/%E5%AD%A6%E4%B9%A0%E6%80%BB%E7%BB%93/"/>
    
    
      <category term="大事记" scheme="https://www.duyidong.com/tags/%E5%A4%A7%E4%BA%8B%E8%AE%B0/"/>
    
  </entry>
  
  <entry>
    <title>AWS 认证分享</title>
    <link href="https://www.duyidong.com/2019/01/08/aws-certification-share/"/>
    <id>https://www.duyidong.com/2019/01/08/aws-certification-share/</id>
    <published>2019-01-09T07:09:40.000Z</published>
    <updated>2019-02-24T14:58:08.414Z</updated>
    
    <content type="html"><![CDATA[<p>2019 年在办公室做的第一个分享，话题是AWS认证，整理成文，记录在此。</p><a id="more"></a><h1 id="目录"><a href="#目录" class="headerlink" title="目录"></a>目录</h1><p>今天的主题主要分为三个部分：首先我们为什么要做这个认证，从自己来讲为什么会想要做这个认证，第二个相信是很多大家来参加这个 Session 关心的问题，就是这个认证是什么样子，考了有没有什么用，然后如何准备，这样的一些相关的问题。然后我最后会给大家分享一下我的学习路线一些学习资料，如果大家有兴趣去了解这方面的内容，这个是比较直接的可以帮到大家。</p><h1 id="为什么要认证"><a href="#为什么要认证" class="headerlink" title="为什么要认证"></a>为什么要认证</h1><p>这是 Gartner 的一个活力象限，大家都比较熟悉。我们来讲为什么我们要学习 AWS 的认证，跟我们有什么关系。我自己是这样看的，因为我自己本身不管是在国内的云厂商也好或者其他的厂商待的时候发现的一个问题是：知识和技能在某一个专业方向的积累一定是要有一个长期的规划的，所谓长期规划呢就是说，如果说有这么一个厂商他自己有这么一套非常完善的方法论，而目前他在整个行业上属于一个非常领先的位置，注意我这个地方说领先我会按照 Gartner 的说法，他首先是个 Visionaries，Visionaries 什么意思，我举个例子就是说他在云这个领域他出什么东西都会比别人早这个就叫 Visionarie；他出了这个产品以后后面有人会跟随，这个就叫 Visionarie，比如说2014年，大家都还在说云计算都只是做一个就是还在上虚拟机的时候，他出了 Lambda， Serverless，这个就很牛了，然后 Serverless 腾讯云和阿里云什么时候跟进的，是去年年初的时候才跟进的，晚了三年，等阿里云介入的时候 AWS 已经 把这个产品做成了一个事实上的标准。所以这就是一个 Visionarie 的表现。然后我们再往上走，Leader 什么叫做 Leader，大家都用，就叫 Leader。AWS 今年 2018 年的市场占有率大约是40%，超过2、3、4 名微软、谷歌、IBM的市场占有率总和。我在项目上有一个感觉，就是你的客户在选择技术栈的时候他要不要去上 AWS。据我所知澳洲，微软的云也有一些 exposure 吧， 但是从全球来看 AWS 的受接受程度真的是蛮高，所以从这个角度呢，这个技术我认为是可以去投资的，至于你投资的具体方式是不是考个证我觉得另说。</p><p><img src="/images/cloud-computing-marketing-rank-2018.png" alt=""></p><p><a href="https://www.skyhighnetworks.com/cloud-security-blog/microsoft-azure-closes-iaas-adoption-gap-with-amazon-aws/" target="_blank" rel="noopener">https://www.skyhighnetworks.com/cloud-security-blog/microsoft-azure-closes-iaas-adoption-gap-with-amazon-aws/</a></p><p>这里有一个看上去比较鼓舞士气的，别人说 2018 年你如果是一个 Certified 的 Solution Arhciture 你可以大概能够拿到12.5万美金吧。这个数字看看就行了，这个严格来说在统计学上是不靠谱的。为什么？大家想一想，这个结论，我觉得在阿里有一个很好的文化就是我们要去看这些事情背后的东西，如果你是一个统计学家你怎么才能证明这一点，这一点必须要有几个因素是说，我同样的一个人，他的能力是基本一样的，他背景一样，教育程度一样，他就多了一个证，所以他的薪水高。对吧，我通过这样的样本来我才能得到这样的结论，但这样的调查其实很难做。</p><p>所以你可以认为说，有一波很牛的人，他们薪水本来就很高，然后他顺带考了一个证。是吧，你可以这样来解释吧，他们本来就很牛，他工资本来就很高了，然后为了证明自己，欸我这个已经很不错了我考个证玩玩儿呗，啪薪水就上去了，这个就被 AWS  拿来做一个很牛逼的数据说，你们都来学我这个证。</p><p><img src="/images/people-said-aws-certifiy-is-valuable.png" alt=""></p><p><a href="https://www.forbes.com/sites/louiscolumbus/2018/03/12/15-top-paying-it-certifications-in-2018/#17711e85623b" target="_blank" rel="noopener">https://www.forbes.com/sites/louiscolumbus/2018/03/12/15-top-paying-it-certifications-in-2018/#17711e85623b</a></p><p><strong>Don’t be high I’ve seen what had happened.</strong></p><p>那我们来说一个，就大家看到这个数据不要太 High，十五年前很流行考的一个 证，CCIE 当时CCIE 的薪酬大家知道是多少，猜一个数字，猜一个薪酬，十五年前，年薪。十五年前一个 CCIE 的薪酬大概是在 50w 左右，那个时候为什么很强势，因为 CCIE 必须要挂靠在合作伙伴这里，合作伙伴必须要有 CCIE 的认证才能拿到 思科的一些资质，这个很重要，所以其实到现在如果说你要纯招一个 CCIE，我觉得人民币大概开到月薪 5000 左右应该可以招到了，5-7k应该可以找到了，就是你不考虑他的任何项目背景，当然我只是说你只是找一个人有 CCIE 这个资质的，你应该是可以找到的，但是如果你要求他有真正匹配的能力和这个丰富的项目经验那是不一定的，那肯定市值是远远超过了我刚刚说的这个价值。</p><p>那这个给大家一个什么样的概念， 就是说，从过去的历史来看，这样的一个认证的出现到他最后肯带是有一个变化，但是目前我仍然比较看好 AWS原因在于我个人认为是比较健康的，比如CISCO 的认证体系包括培训体系和认证体系其实被社会上这种帮你拿证这种风气给搞混乱了。所以目前来看我认为 AWS 是比较有投资价值，就相当于说，他的这个难度，可以吸引很多人去考，而他的难度并不能够保证你能够轻易地通过，所以我认为这个是比较有价值的。然后第二个投资价值就是我刚才讲的 AWS 在市场上是有号召力的。</p><h1 id="为什么-AWS-需要认证体系"><a href="#为什么-AWS-需要认证体系" class="headerlink" title="为什么 AWS 需要认证体系"></a>为什么 AWS 需要认证体系</h1><p>为什么AWS 或者思科这样的公司会推出这样的 Ecosystem。其实认证，是可以帮助他去建立这样的 Ecosystem 的，比如说 AWS 要求他现在的合作伙伴，据我所知，在中国区现在他最牛的一个 AWS 合作伙伴公司，是需要公司有 8 个 professional 这样资质的人，然后有 20 个 Associate 这样 level 的人，所以他会对他建立他的合作体系会有好处。然后第二点，就是在企业我招人的时候我可以很轻松地 Identify 这个 skill，能够很快地选择合适的候选人，这个作为入门的门槛。然后第三部分呢他也为这种规范化比较系统化的学习提供了一个合适的框架，这个是为什么企业巨头要去设置这种认证体系的几个原因吧。</p><p><img src="/images/aws-partners-consulting.png" alt=""></p><p><a href="https://aws.amazon.com/partners/consulting/" target="_blank" rel="noopener">https://aws.amazon.com/partners/consulting/</a></p><h1 id="我为什么要考-AWS-的认证"><a href="#我为什么要考-AWS-的认证" class="headerlink" title="我为什么要考 AWS 的认证"></a>我为什么要考 AWS 的认证</h1><p>那么从个人来说，我为什么去选这个证。首先第一个就是，我认为他就是一个 Measure，一个度量，我自认为我对这个AWS有比较多的了解，但是到底到了哪个阶段到了哪个水平，我需要一个相对客观的标准，这个是我考这个认证的一个初衷。然后接下来一点我认为是一个自驱动，很多时候你会去学一个东西，或者说是去想掌握很多东西的时候你需要设定一个目标，那这个 Goal 是最容易设的，我通过几个月的学习，我可以拿到这样一个认证，设定这个目标是一个比较容易的办法；然后第三个呢就是持续学习，这个持续学习我想强调的是，即便你通过了这个认证，首先他在这个规则上是要求你重认证的，每两年你要重复认证，所以这是给你一个持续学习的压力，然后第二个他还可以给你提供持续学习的机会，就是当你取得这个认证之后，很多人就会来向你咨询很多关于AWS的问题，或者公司有项目也可以过去支持一下，很多问题我刚听到也不知道怎么办，但是可以查资料，可以去继续深入了解，在这个过程中我获得的收货，可以说不亚于在考证时候学习的收货；然后第四个 Endorsement 就是你在做这种行业上的交流的时候你可以证明你可以具备相关的经验和能力，当你在跟别人沟通的时候，你自己说我是通过认证的，那么别人对你的期望值是不一样的；当然最后一个大家可能也有期望值但是我必须要浇盆冷水的就是这样的认证基本不会在你的 Money, Permotion , Salary，或者说 next job 上发挥特别大的作用。我再举一个例子，如果三个人，一个人是有认证的，一个人不光有认证还有丰富的经验，然后第三个人是没有认证但他有非常多的经验，其实这个筛选过程会很快对不对，可能第二个人他的胜算会大一点，因为别人有认证我肯定可以过第一轮筛选对不对，但是你被筛选过后你是不是具有相关的实践经验你在项目上到底用过了AWS的哪些产品，这个东西一问就出来了，所以对最后一条不要有太多的期望值。</p><p><strong>如果再举一个例子来形容，我觉得这个故事可能会比较形象一点，就好比说你去爬山，在爬山你启程之前你给自己做了一个 lunch box 上面你贴了一个封条说：“只有爬到封顶我才能打开它，我才能吃”，然后你就去享受你爬山这个过程克服了很多的困难，然后到最后你把这个 lunch box 打开吃掉。我认为认证在某种程度上就是这个 lunch box 。就是一个 Lunch box，你最终的收获和体会其实是在这个过程中，这个对你是最重要的。</strong></p><h1 id="架构路线图"><a href="#架构路线图" class="headerlink" title="架构路线图"></a>架构路线图</h1><p><img src="/images/aws-certification-level.png" alt=""></p><p><a href="https://aws-chalktalk.com/certification/" target="_blank" rel="noopener">https://aws-chalktalk.com/certification/</a></p><p>好我们来看看不同认证的要求，我刚刚说了我做得是 Architect 的认证，我 high light 几个关键词，大家就可以去选择自己感兴趣的方向了。第一个就是你如果是 Architect 你是做 Designing 和 Deploy，Architect 你着重的是了解用户的需求，然后在架构设计上把它设计出来，说，我要什么样的架构来实现这样的功能点，然后你把它实现出来就行了。Ops 和 Develolper 就不一样，Ops 强调的是我如何通过一些 hands on 的一些操作，我能够 deploy 它，mange 它，operating 它。那 Developer 更多的是跟 AWS 已有的东西去打交道，因为 AWS 有一个非常强悍的地方是它基本上所有的东西都会有 API 和 SDK，那意味着 Developer 以前是在于开发自己的软件，现在这个概念已经变了，在于说我 Developer 可以以开发软件的方式去管理我的infrasturcture,这个就变成了 infrasturcture as code,对不对，就这样类似的一些概念，架构即代码，代码即架构。所以，如果大家去选择不同的类型的，可以和工作的相关度和自己的兴趣来看自己，从哪个点切入是比较合适的。</p><h1 id="关于考试"><a href="#关于考试" class="headerlink" title="关于考试"></a>关于考试</h1><p>一些关于考试的基本信息，首先这个考试都是远程，是在一个房间里面，然后不能带任何资料。然后呢，考试费用是 Associate level 是  150 美金，Profession level 是 300 美金；然后有一个时间的问题，时间是在 80 分钟内做若干道题 professional 要求是在 170 分钟。然后通过率呢其实是动态调整的，他会根据来考的人这样的一些水平来通过一些算法，保证一定比例的人通过，不是说我 60 分及格这样的，然后这个考试有一个好处就是考完马上就可以拿到成绩，然后通过以后这个认证的有效期是两年，这个有一个很合理的原因。这个有一个非常合理的原因，因为每两年 AWS 就开发出了非常多的功能。你需要 matain 你的技能，你需要继续的展示你的经验和能力，理论上你需要去更新这个考试，这个更新考试呢是类似的一个题，但是量会少一些，价格也会便宜一些。所以一般来讲你说我是这个 AWS 认证，会要求你说，这个认证有效期是多久。这个也是保证证书有价值的一个必要的手段。不是说我考完就可以管一辈子。</p><p>具体和考试有关的一些内容，几乎全部都是多项选择题，我记得应该是没有不定项，都是多项选择题，然后呢不会有这种 hands on 说你你去配一个指令这种。然后第二呢几乎不会有这个命令行的这个操作界面，你对 webconsole 足够了解就可以了，不会说你要去敲一个命令如何组合。然后第三点就是我要说的宽度而不是深度。</p><p>宽度是什么，大家看 AWS 目前已有的服务，目前的考试大纲应该是覆盖了里面 70%-90%的产品，因为考试大纲会比服务发布有一些滞后；换句话说，每一个产品，至少在构架的 trail 里你是需要了解这个产品能做什么，不能做什么，它怎么跟其他的服务集成，它基本的一些操作，它在控制台里面哪些属性是可以配的哪些是不能配的。所以，这个量很大，注定了这个考试不是一个往深了考的考试，而更多的是说我要要求你知道你在架构里你要知道这个东西是干什么的，在什么场景下需要把它组合到一起，因为它的产品实在是太多了。</p><p><strong>样题1</strong></p><p>然后呢我拿两道样题，这两道样题是公开的。我们来推敲一下他会考察大家什么样的内容。其实所有的问题在考试里面会遇到两种，一种就是客观的东西，他是一种客观事实， 这个一定会有对错，就是比如说 galcier 在那种场景下是可用的，他一定会在某种场景下是可用的，在别的场景下就不好用或者不能用的。还有一类问题是一类场景。</p><p><img src="/images/aws-example-1.png" alt=""></p><p><strong>样题2</strong></p><p>他给到你一个场景之后你会有一个限制条件， Associate level 你可能选的是一个对的答案，就是说，this is good, this is  right one，其他的都是错的。但是在 Professional level 你需要做的是 chose the best answer, 他会给你一些限制条件，比如说我们来看这道题，我们只读一句话，中间这句话，他说，在这个复制应用到到 AWS 环境之后哪个选项允许你把这些数据放到 AWS 上 without losing any data and within the given timeframe，如果是 Associate level 我可能里面就一个选项说我可以把它搬过去。但是他给的条件是第一你不能丢数据，第二你必须在 given 的 timeframe，那你的选项就必须要认真地去读，可能四个都能干这个事，但是你必须要做的是 the best answer。</p><p><img src="/images/aws-example-2.png" alt=""></p><h1 id="如何备考"><a href="#如何备考" class="headerlink" title="如何备考"></a>如何备考</h1><p>如果说要准备这个考试的话我建议说可以从哪几个点。首先第一个点就是，基础知识。这个基础知识是为了应付这个对和错的问题，这个还不涉及场景，那我举一个例子，大家能不能说说这个 durability 和 Availability 和 integrity 的区别？如果我们把他们投射到 AWS 具体的产品上面，我挑 S3 或者 Glacier 来对比，大家觉得 Durability S3 做得怎么样， 11 个 9, availability 是多少，只有四个 9，所以这个就有区别了，Durability 说我数据我放在 AWS 上，我不丢，AWS 的官方解释是 我 10w 个数据放到 AWS S3 上 我在 大概 1000w 年的时间里会丢一个。这个就是 11 个 9 的概念。那 Availability，这个业界有通用的描述，就是我在一年以内，我有多少分钟不能访问，对吧，这个 是 Availability，那 Integrity 是说我数据不会被改掉。那么这个就可能是有一个思路是，那我存一个数据，我对这三个方面的要求是什么，针对这些要求，你选择一个恰当的存储。所以这些都是非常基础的知识。你需要真的是很细地去看。</p><p>然后第二个：足够的熟悉 Web console，为什么需要足够的熟悉 Web console，是你如果光看白皮书你去看这个产品有什么功能你的理解是很肤浅的，或者说不够直观，但是只要你看了 webconsole 你就会有一个概念说，这一产品我需要有三个参数需要在第一页配，第二个参数需要在第二页配，他们之间有没有什么关联，你把这一个路径走完，你基本上会对这个理解深非常多。其实换句话说，我不算是重度用户，但是我在不是很频繁，账单可以保持在一个月十几美元，就说明你用得足够多了，其实 AWS 很便宜的，而且初始用户都有一年的免费的叫 FreeTier 可以去选，然后你足够熟悉去用它，这个对你的理解会好很多，这个投资一定是值得的。</p><h1 id="解题思路"><a href="#解题思路" class="headerlink" title="解题思路"></a>解题思路</h1><p>回来看样题2。我们可以用<strong>“Scenario”-&gt;”Goals“-&gt;”Constraints“-&gt;”Components“-&gt;”Structure”</strong>五个点来分析这道题。 Scenano，这个 Company 是一个已有的老旧的系统，900个G已经在 Server 上了，就是他的现状。它会讲说更新的这个频率，百分之多少更新，这些都叫 Scenario；Goals，很明确要做迁移，要迁移到 AWS；再进一步分析，Constrains 在哪里，不能丢数据，然后是在 given 的 time frame，一旦涉及到 given 的 timeframe 就立刻会想到这个 45M 的 internete connection 是不是个瓶颈，那个这时候就会提醒你了，把这些信息整合到一起了，在你熟悉 component 的前提下，你先得熟悉 component，每个产品知道他干什么的，他的优势在哪里，不能做的是什么，能做的又是什么，他的成本高不高，然后，以一个合适的逻辑方式把它组合起来，Structures。其实这一点我不得不赞一下 AWS 的考试，我觉得他这个考试很贴合实际，因为这些都是你实际在考试工作中遇到的，比如说我作为一个真正的就是说在实际的工作环境下我要做一个架构师，我其实面对的就是这个场景。就是客户说，我跟你讲一讲我们公司现在什么什么情况，然后要达成什么目的，有什么限制条件，来给我出一个方案，这个就是架构师应该做的事情，所以我觉得 AWS 这个考试的含金量在这个地方也是我比较认同他的这一点，我认为这个跟现实的环境其实蛮像的。</p><p><a href="https://aws.amazon.com/architecture/" target="_blank" rel="noopener">https://aws.amazon.com/architecture/</a></p><p><a href="https://media.amazonwebservices.com/architecturecenter/AWS_ac_ra_loganalysis_11.pdf" target="_blank" rel="noopener">https://media.amazonwebservices.com/architecturecenter/AWS_ac_ra_loganalysis_11.pdf</a></p><h1 id="学习资源"><a href="#学习资源" class="headerlink" title="学习资源"></a>学习资源</h1><p>接下来我说一下这个学习的资源有哪些吧，最最直接的资源其实就是 AWS 的官方文档，然后还有一个是 video，video 在 yotube 上你基本上可以搜到你想看的所有主题，video 的很多东西他是往深了走，你如果光从这个考试的角度上，比如说你其实一个两个小时的 session 你真没必要听完，你就自己选自己觉得感兴趣的，或者这种纲领性的东西你听个大概半个小时其实就够了，因为他很多其实会走非常细的一些东西，从考试这个角度我觉得你没有必要全部听完，当然你如果是希望掌握这些技能，那你一定要去好好的看。然后第三方呢有很多这个 website，然后会有这个 online 的 seminar，当然有真正由AWS 认证讲师去讲的这种 trainning program，但是这种也比较贵，大概是几千块钱接近一万块钱的接近两到三天的这样的一个培训。然后最后一条就是你自己的 customer case。</p><p><strong>官方文档</strong></p><p><img src="/images/aws-documentation.png" alt=""></p><p>Official Documents on <a href="http://aws.amazon.com/" target="_blank" rel="noopener">aws.amazon.com</a></p><p>这个图其实AWS 的文档体系，先不看红色的框，我们只看这个就是整个的结构，他其实分为整个的这么几块，产品维度，有三个文档，一个叫 developer guide，你可以理解为这个就是 hands on 的一个指南了，就说你要用这个产品，你所有的操作怎么样，他所有的文档都叫 developer guide，你不要以为只有 developer 才会用，然后就是 API,API 很少用到，因为至少架构的考试里面是不会涉及 API 的。然后非常重要的是 FAQ，就是大概说这个产品能做什么不能做什么，就简单的包括计费。</p><p>上面这三个都是具体跟产品相关的，然后往下面就是深入到方案场景了，这个时候其实就是体现我其实不是一个产品，是多个产品的有机结合，那么这个时候首先有一个快速上手，快速上手是针对一个特定主题，比如说，我如何用 AWS 部署一套 wordpress，那么这个时候你可能会用到 S3，用到 EC2，你可能会用到 cloudfront，那么这些东西你怎么去把它部署起来，这个就是快速上手，然后呢会有客户案例，还会有白皮书。 白皮书呢其实也是针对一个特定主题去讲，包括一些合作伙伴白皮书，这个合作伙伴是指技术上的合作伙伴，那么如果他们之间，比如说 ACP Hannah 跟 AWS 会有关联，那么他会有一些介绍。然后，一些快速参考部署，然后参考架构和架构白皮书，所有里面我红框框出来的我认为是对架构考试会非常有帮助非常重要的，可以这样说，只要是 AWS 用红框框的这些内容我都会读。</p><p><strong>AWS 白皮书</strong></p><p>这部分内容可以参见我的另外一篇文章：<a href="https://www.duyidong.com/2017/03/23/AWS-well-architected-framework/">https://www.duyidong.com/2017/03/23/AWS-well-architected-framework/</a></p><p><strong>AWS 架构图</strong></p><p>好，这个图是我刚刚讲过类似的一个图，这个图也是按我们刚刚的一个分析其实大家从这个图里面可以获得很多的信息，第一个就是用到的产品，然后，他解决的是什么样的一类问题，然后系统连接和组件。如果你能对所有场景，都能够抽象出这种图来，那么你对整个 AWS 架构就会非常熟悉了。无论是用相关的一些 Icon 还是你用白板自己在白板上画，你能够把任何的场景用这个图来表示，说明你对这个架构已经足够深的了解了。</p><p><img src="/images/aws-architecture-map.png" alt=""></p><p><a href="https://aws.amazon.com/architecture/" target="_blank" rel="noopener">https://aws.amazon.com/architecture/</a></p><p><strong>Write it down</strong></p><p>好，然后这里我要特别强调一点，在学这个过程当中会发现一个东西，你不停的学，不停地看，你看了很多，你记不住，至少对我而言，因为我记性不是很好，所以我的一个习惯是一定要把它写下来，我会怎么写，恰好我通过认证了以后我也看了下我这个记录，也回顾了一下我这个准备的时间。当然也不是为了这个认证准备，就是AWS笼统的这个学习时间，我的第一篇日志是xxx实践写了，然后我的最后一篇日志也就是取得认证的时候是 xxx写的，然后我中间大概有一年大概是在xxx只有四篇日志，所以我的节奏基本上是如果我看到了这个东西，我哪怕是读了一个 vedio,我就去截屏，然后把它重点 hight light 下来，然后把它的重点，你觉得真正有价值的东西，把它记录下来，否则我觉得这个转化率或者我个人能够掌握它的程度真的会非常有限。所以我就按这个适合我个人的方法来做，当然我不确定这个所有人都适合，我举个例子，我会怎么去写。</p><p>这里附上一个我和 AWS 有关的日志列表：<a href="https://www.duyidong.com/categories/Amazon-Web-Services/">https://www.duyidong.com/categories/Amazon-Web-Services/</a></p><h1 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h1><p>最后我总结一下，目前看来我认为这个认证是值得投资的。但是如果说你不需要这样的一个目标的设定，不需要这样的方式你依然可以在项目中积累足够的经验，仍然能达到这样的一个的水平。</p><p>更多的信息，可以参见我两年前写的一篇博客：<a href="https://www.duyidong.com/2017/04/05/How-to-pass-the-aws-certification/。谢谢！">https://www.duyidong.com/2017/04/05/How-to-pass-the-aws-certification/。谢谢！</a></p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;2019 年在办公室做的第一个分享，话题是AWS认证，整理成文，记录在此。&lt;/p&gt;
    
    </summary>
    
      <category term="Amazon Web Services" scheme="https://www.duyidong.com/categories/Amazon-Web-Services/"/>
    
    
      <category term="AWS" scheme="https://www.duyidong.com/tags/AWS/"/>
    
      <category term="云计算认证" scheme="https://www.duyidong.com/tags/%E4%BA%91%E8%AE%A1%E7%AE%97%E8%AE%A4%E8%AF%81/"/>
    
  </entry>
  
  <entry>
    <title>从 ThoughtWorks 到阿里巴巴</title>
    <link href="https://www.duyidong.com/2018/10/24/from-thoughtworks-to-alibaba/"/>
    <id>https://www.duyidong.com/2018/10/24/from-thoughtworks-to-alibaba/</id>
    <published>2018-10-24T21:26:35.000Z</published>
    <updated>2019-02-24T14:58:08.414Z</updated>
    
    <content type="html"><![CDATA[<p>拿到阿里巴巴的 Offer，即将离开 ThoughtWorks。在刚入职 TW 的时候就有同事告诉我“入职第一天就想着离职的员工才是好员工”，我的 Sponsor 也随时在提醒我做决定的时候想想“当你离职的时候你能在你的简历上写些什么”。正是这种关注个人成长的文化激励着我即使在无聊的项目上也没有放弃学习，为随时可能到来的变化做好充分的准备。</p><h1 id="在-ThoughtWorks-的经历"><a href="#在-ThoughtWorks-的经历" class="headerlink" title="在 ThoughtWorks 的经历"></a>在 ThoughtWorks 的经历</h1><h3 id="ThoughtWorks-有大牛吗？"><a href="#ThoughtWorks-有大牛吗？" class="headerlink" title="ThoughtWorks 有大牛吗？"></a>ThoughtWorks 有大牛吗？</h3><p>有肯定是有的。但刚进公司时，这是曾是我最大的困惑，入职 ThoughtWorks 之前在网上看过不少 ThoughtWorker 的博客，觉得这里应该有很多技术很牛的人。那个时候我对牛人的定义就是写代码很厉害，手也快脑子也快，别人眼里的技术难题他看一眼就能解决。现在加入 ThoughtWorks 两年半，我很少会因为代码觉得某位同事很厉害，反而是在开会的时候，或者看别人 PPT 的时候觉被某个人体现出来的学识折服。同事们口中“厉害的人”的特质可能更倾向于“思路清晰，反应迅速，谈吐流利，做事专业”。后来我明白我期望和现实中的差别是公司性质决定的，ThoughtWorks 是一家咨询公司，这些优秀的同事身上有“咨询公司”所需要员工具备的能力。</p><h3 id="项目内外"><a href="#项目内外" class="headerlink" title="项目内外"></a>项目内外</h3><p>在 ThoughtWorks，我经历了五个项目，从云迁移到 CI/CD 搭建，再到 2C 应用编写，到现在的 E2E 团队，应该说并没有遇到过特别大的技术挑战，大都数时候都是在写一些业务逻辑，改改样式，有意思一点的项目启动大致也就是如何把开源产品拼凑起来搭建一个流水线。不过敏捷这一套做事方式我觉得还是很有价值的。</p><p>而且好在项目比较轻松，给了我很多自由学习的时间看书、写 PPT。在 Session 和 Workshop 中，一遍又一遍重新定义 DevOps，把容器化技术学到了比较底层，整理了客户整个的网络架构和基础设施，AWS 拿到了架构师认证。真正的成长都是在项目之余。</p><p>最近一年时间我写了非常多的 PPT，有打单的，有架构设计的，有咨询的，有一段时间我几乎觉得自己是一个 PPT 工程师，也正是那段经历打消了我做咨询或者售前的想法。没有扎实的沉淀就做一味的输出是非常危险的，厚积薄发才是理想状态。这就要说到另一个项目内外不联动的弊端，就是在做对外培训或者分享没有真实案例做支撑，只能讲一些书本上的，自己小 demo 里面的，有时候甚至是别人博客里的一点东西，这种方式可能对于对这种技术一无所知的听众有所帮助，开了开眼界，但是对于真正想要学习这门技术的人来说，同样的内容他们也可以用跟讲师完全相同的方式获得。对于个人收获而言，网上看来的技术不利于深入探讨和沟通。</p><p><img src="/images/goodbye-thoughtworks.jpg" alt=""></p><center><strong>【ThoughtWorks 成都办公室】</strong></center><h1 id="一些经验和收获"><a href="#一些经验和收获" class="headerlink" title="一些经验和收获"></a>一些经验和收获</h1><p>做事方法，是我在 ThoughtWorks 学到最有用的东西，这里给大家分享一下，一部分来自于我平时工作中的总结，一部分来自于培训笔记结合一些实践的体会。</p><p>敏捷项目里有 BA、QA、Dev、IM。我把我自己在公司扮演过的角色分为三个：开发（团队成员）、分享者（社区活动）、TL（Team Lead/Tech Lead，团队负责人）。</p><h2 id="作为一名开发"><a href="#作为一名开发" class="headerlink" title="作为一名开发"></a>作为一名开发</h2><h3 id="如何发英文邮件"><a href="#如何发英文邮件" class="headerlink" title="如何发英文邮件"></a>如何发英文邮件</h3><p>邮件是最日常使用的技能，恰巧也是最体现专业性的地方。在 ThoughtWorks 平均每天要写三封英文邮件，沟通需求，会议总结，商讨技术方案。邮件的目的在于传递信息，所以要求高效，因为邮件便于追踪，他还应该承载足够的信息便于日后查阅。写邮件好比写文章，一个简洁有力的开头，详实有条理的中间，一个非常绅士的结尾必定会给收件人一个好的印象。</p><ul><li><strong>Say Hi：</strong>Dear 常用于正式场合，Hi 更常用些。</li><li><strong>简短的开始，表明意图</strong>：一句话告诉接受邮件的人，你写这封邮件是希望对方做什么，这样可以省去不需要详细阅读邮件的人的时间，也可以抓住目标观众的眼球。<ul><li>有件事(问题，项目)想跟您(各位)确认/请示/请教/汇报…. </li><li>I am writing to…  </li><li>I was wondering if you could…  </li><li>Let me explain/share/offer/provide/add….. </li></ul></li><li><strong>邮件中部，写明来龙去脉：</strong>用词清晰简洁，最好分点论述，如有配图最好放在邮件尾作为附件查看。如有祈使句务必使用问句，避免过于生硬。<ul><li>Could you please…  </li><li>I would appreciate it if you could… </li><li>If possible, I wonder if you could… </li></ul></li><li><strong>结尾，表达沟通意愿：</strong><ul><li>If you have any questions, please let me know.  </li><li>If there is anything unclear, please feel free to ask me. </li><li>If you need any further information, please let me know and I shall be pleased to provide it. </li><li>Happy to help if you have any questions (or need further information). </li></ul></li><li><strong>签名：</strong>保持邮箱设置有签名的习惯，写明你的姓名、联系方式，对公邮箱还需要写明公司和职位。问候语使用：<ul><li>Thanks,</li><li>(Best/Kind/Warm)Regards,</li><li>Yours sincerely,</li></ul></li><li><strong>邮件主题：</strong>类似于邮件第一句话，不过要更加简短，确保所有收件人看到主题就知道你要说什么，最好加上标签如【重要】[help] 等等。</li></ul><h3 id="如何-Feedback"><a href="#如何-Feedback" class="headerlink" title="如何 Feedback"></a>如何 Feedback</h3><p>Feedback，其实主要是沟通。Feedback 的一条准则我非常喜欢，叫作<strong>基于事实而不是基于判断</strong>，听起来很容易但做到却很难。典型的一个场景就是互相指责“我觉得你该xxx”。如果一个讨论是基于双方的主观意愿进行的那就容易变成“各说各的”，很难达到一致，讨论效率低下。Feedback 有一个模型用于解释我们应该基于什么样的事实进行反馈：如下图所示，信仰，态度，习惯不要给 Feedback；以及注意对事不对人，以帮助他人为出发点，越具体越好。每次我在和别人争论事情或是想要给某人提意见的时候我都会思考一下：这种情况是不是适合给 Feedback，我提这个意见真的是为了他能有所提升吗？他采纳我的意见之后真的会变得更好吗？思考这些问题可以避免善意的提醒变为指责。</p><p>Feedback 结构可以是：”我看到。。。我觉得。。。你是怎么想的？ “。好的 Feedback 还要及时，越早越好，不然容易变成翻旧账。除此之外，给 Feedback 之前要确保安全的环境，可以在沟通之前先问“现在合适吗？”，如果大家都在情绪激动的时候还是要以安抚情绪为主；给完 Feedback 以后接受者不要忘了说“谢谢”。<br><img src="/images/when-do-not-give-feedback.png" alt=""></p><center><strong>【什么情况下不要给 Feedback】</strong></center><h2 id="作为一名分享者"><a href="#作为一名分享者" class="headerlink" title="作为一名分享者"></a>作为一名分享者</h2><h3 id="如何做-Session"><a href="#如何做-Session" class="headerlink" title="如何做 Session"></a>如何做 Session</h3><p>在一家技术氛围很好的公司通常都是很鼓励分享的，我在  ThoughtWorks 最高产的一年做过二十多次分享。<strong>从 “Why” 到 “How”</strong>是我在帮别人 Rehearsal 的时候经常提到的点。很多人在讲 Session 时容易犯的错误是只讲“How”不讲“Why”，例如技术人员喜欢在 Session 一开始就介绍某某工具的历史，如何使用，有什么特别好的功能。这些对于第一次听这个话题，没有足够上下文的人来说太细节了。你需要为了听众回到你刚开始接触这个工具时的场景，回答一个问题：“<strong>我们为什么需要这个工具</strong>”。你可以通过“这个工具解决了什么样的问题”引出，例如说开发或者运维过程中存在着一、二、三的痛点，列举痛点一定要让人一目了然，最好有真实简短的案例作为说明，或者有数据支撑。有了问题的铺垫，然后才是“这个工具如何解决了上述问题”，可以使用对比的方法，例如使用这个工具之后，某某指标下降，开发体验如何得到了提升云云。最后可以再加一个还有哪些工具是为了解决同样问题产生的，从各个维度进行对比，帮助不同的项目场景做技术选型的一个参考。还可以提及为什么我们当下的业务场景没有使用其他工具。亦或是使用这个工具的成本，引入了什么新问题。还可以结合这个工具最新的版本和社区声音展望一下这个工具未来会有什么功能，现场讨论一下，都是可以的。</p><p><strong>提出问题-&gt;解决问题-&gt;发散上升</strong>。这样的结构在我看来就是一个扎实的 session，可以看出，在这个结构中，“工具是怎么样的（How）”这个问题是最不重要的，因为听众只是想要在你的 session 中对这个工具有个感性认识，知道它的一些使用场景，就达到了参会目的。至于具体如何使用，我相信大部分人可以借助文档在很短的时间里通过看文档学会，前提是他们真的需要知道。</p><p>千万不要把你在网上博客里看到的内容随便就拿来讲 Session，因为你讲出来的东西，别人花一两个小时在网上看看博客也能看得到。</p><h3 id="如何做-Workshop"><a href="#如何做-Workshop" class="headerlink" title="如何做 Workshop"></a>如何做 Workshop</h3><p>Workshop 工作坊，不只是培训，还可以作为一种讨论的形式，用来形成计划或方案。例如针对一个困难、复杂的问题，搜集信息、找出问题、统一目标、制定方案、拆解任务，每一个环节都可以是一个 Workshop。我们在日常工作中除了培训最常遇到需要 Workshop 形式就是给团队（客户）引荐某种技术、实践或者解决方案。要让客户买单，让团队达成一个共识可不是一件容易的事情，会议上不能只有你一个人说话，因为不说话的人，脑子里想的可能和你以为的完全不一样；也不能所有人都说，这样容易失去焦点。因此如何组织好一次高效的会议，和做一个 Workshop 需要的技巧其实是一样的。</p><ul><li>Workshop 开始前（5P）<br>确保所有人员、物料到齐，发邮件，订会议室，沟通团队成员时间，跑动要积极一点。<ul><li>Purpose：参与者共同制定目标、有备选第二目标、有明确的产出、了解背景</li><li>People：识别干系人，并邀请到工作坊中，其中包括：执行者、决策者、信息输出者、受结果影响的人 </li><li>Process：议程、时间、地点、技巧、物料、可能遇到的问题、以及问题解决方案 </li><li>Product：行动方案、达成了共识、工作坊的遗留问题、收集到的信息、明确产出物 </li><li>Pitfalls：可能会出现的问题、例如: 成员不积极、期间产生激烈的冲突、没有相关信息输入、设备物料出现故障、工作坊目标无法达成 </li></ul></li><li>工作坊开场（4P 1I 1G）<br>主要是调动情绪和明确产出，同时宣布纪律和流程。有很多小技巧，比如大家一起制定 Ground Rules，保证每个人都同意不玩手机，以集体的名义向个人施压；还有我最喜欢的 Parking Lot，很多时候会议上会有人把话题带偏，或是有的人就钻到一个牛角尖里出不来，这个时候作为会议组织者可以说“这个问题我们放到 Parking Lot 里面接下来再讨论”，既让问题的提出者得到了尊重，又保证会议可以正常进行下去。<ul><li>Purpose：明确目标和产出 </li><li>Process：明确议程，介绍工具、设置预期、工作坊中提醒大家保证按计划进行、进展如何 </li><li>Parking Lot：介绍如何使用、避免遗漏有价值的议题、重视参与者的输出 </li><li>Participants：参与者的角色和重要性（明确职责）、赋予他们工作坊中的相关责任、介绍参与人角色，避免尴尬 </li><li>Icebreaker： 调动参与者情绪 </li><li>Groud Rules：保证秩序、共同制定规则、设置规则警察、避免“破坏性行为” </li></ul></li><li>工作坊进行中<br>主要是调动气氛，掌握好发散-&gt;收敛-&gt;发散-&gt;收敛的节奏，确保关键角色（Stack Holder）在每一个环节对问题的认识都达到了一致，灵活使用各种发散收敛的工具，借助可视化（画图，贴纸）进行视觉传达。<ul><li>调动气氛的核心是吸引学员注意力并点燃自己</li><li>注意肢体语言、口头表达的精炼程度、面部表情、语音语调、口头禅等</li><li>12种调动气氛的方法：鼠－热情、牛－案例分析、虎－控场、兔－会讲故事、龙－会微笑、蛇-会放视频、马-讲笑话、羊-做游戏、猴-给奖励、鸡-会运动、狗-热点问题、猪-提问题</li><li>用视觉的笔记形式，更好的辅助工作坊。</li></ul></li><li>工作坊之后<br>一个漂亮的收尾可以提现出专业性，整理工作坊的产出并发送邮件应该是最简单的方式，不要忘了把 Parking Lot 里的东西加上。还可以用各种方式搜集到与会人员的反馈，帮助你下一次做的更好。最后有一些关于 Workshop 的小 Tips:<ul><li><strong>内容设计围绕学员进行设计、调整</strong></li><li><strong>交互与气氛&gt;讲义与脚本</strong></li><li><strong>白版与贴纸&gt;播放PPT</strong></li><li><strong>现场投入&gt;照本宣科</strong></li><li><strong>寓教于乐&gt;灌输知识</strong></li></ul></li></ul><p><img src="/images/tw-workshop.jpg" alt=""></p><center><strong>【一次公司内部的 Workshop】</strong> </center><h2 id="作为一名-TL"><a href="#作为一名-TL" class="headerlink" title="作为一名 TL"></a>作为一名 TL</h2><h3 id="如何和团队成员沟通"><a href="#如何和团队成员沟通" class="headerlink" title="如何和团队成员沟通"></a>如何和团队成员沟通</h3><p>沟通太重要了，敏捷里的所有会议，都是在强调沟通。如果说N v N  的沟通是要确保每个人围绕观点充分表达，那么 1 v 1 的沟通就是要走心。作为一个团队领导和团队成员沟通的时候是有很多技巧的，比如在一次谈话开始前可以准备以下步骤：</p><ul><li><p><strong>定方向：说明讨论目的；说明讨论重要性；建立积极氛围。</strong><br>开场即说明此次约谈意图，避免听者猜测，带来隔阂和不信任感。也让谈话建立起一个关注点。</p></li><li><p><strong>理情况：了解问题原因；对象担心和顾虑所在；分享自己的观点和信息。</strong><br>这一步属于谈话的发散阶段，主要是让被谈话者多说，一定要在每段谈话的结尾说“还有吗？”，给对方充分的时间思考，确保挖掘完对方所有的想法。</p></li><li><p><strong>想方案：积极鼓励对方的参与，共同思考解决问题的方法。</strong><br>在开始这一步之前先总结理情况的一步，对前面的发散有一个收敛，如果对方是倾诉式的表达，一定要先表示“我认同你的感受”，然后将对方表达的内容总结出来“你说了以下几点，一、二、三。。”然后将问题快速地排一个优先级或者把问题归纳到三个问题以内，再来想解决方案。想解决方案的时候先问对方“你觉得可以怎么样”，同样在回答完之后不要忘记问“还有吗？”，确保所有解决方案都被相到。</p></li><li><p><strong>明做法：与对方就行动步骤达成共识，并进一步商讨如何追踪。</strong><br>明确行为产出，应该是谈话产出的重要内容，一起定义做到何种程度我们认为是“好”了，可以确保我们的目标更加一致，也便于后期追踪验收。</p></li><li><p><strong>做总结：突出讨论重点，以积极的语调结束谈话。</strong><br>其实整个谈话过程 Leader 都是起到一个 facilitator 的作用，提出问题，引导，帮助梳理，最后是总结。总结的时候要注意高亮出谈话的重点帮助被谈话者记忆，最后加上一句发自内心的肯定：“进公司以来你一直表现不错，相信这次挑战对你来说不算什么！”给别谈话者正向地影响。</p></li></ul><h3 id="如何-Retro"><a href="#如何-Retro" class="headerlink" title="如何 Retro"></a>如何 Retro</h3><p>Retro 又称迭代回顾会议，常发生在两个迭代之间，用于总结前一个迭代的得失，以求下一个迭代做的更好。在 ThoughtWorks retro 无处不在，做了一个 Meet up 之后，一次培训的结尾，一个项目的结束，都会有 Retro，我个人甚至把 Retro 带到了生活中。Retro 的 Well/Less well/Suggestion 事实上建立了一种思维模型，告诉我们在一个事情结束之后我们如何从好和不好的角度审视它，以及制定下一步的改进计划。Retro 还可以确保团队成员充分沟通，TL 可以借此了解每个成员对于团队的想法。</p><h1 id="关于阿里巴巴"><a href="#关于阿里巴巴" class="headerlink" title="关于阿里巴巴"></a>关于阿里巴巴</h1><p>如果说 ThoughtWorks 是一个愿景类公司，阿里巴巴的定位则要更实务一些。可以预见在新的岗位上会有更高强度的工作节奏，和更关注真实用户的产品。希望能在阿里巴巴成长为一个在云计算领域有一定影响力的人，有着扎实的基本功，出色的沟通表达能力，和宽阔的技术视野。这一切，都是要坚持不懈的努力才能换来的。</p>]]></content>
    
    <summary type="html">


        &lt;p&gt;拿到阿里巴巴的 Offer，即将离开 ThoughtWorks。在刚入职 TW 的时候就有同事告诉我“入职第一天就想着离职的员工才是好员工”，我的 Sponsor 也随时在提醒我做决定的时候想想“当你离职的时候你能在你的简历上写些什么”。正是这种关注个人成长的文化激励着我即
      
    
    </summary>
    
      <category term="ThoughtWorks" scheme="https://www.duyidong.com/categories/ThoughtWorks/"/>
    
    
      <category term="ThoughtWorks" scheme="https://www.duyidong.com/tags/ThoughtWorks/"/>
    
      <category term="大事记" scheme="https://www.duyidong.com/tags/%E5%A4%A7%E4%BA%8B%E8%AE%B0/"/>
    
      <category term="阿里巴巴" scheme="https://www.duyidong.com/tags/%E9%98%BF%E9%87%8C%E5%B7%B4%E5%B7%B4/"/>
    
  </entry>
  
  <entry>
    <title>变化和存在</title>
    <link href="https://www.duyidong.com/2018/08/07/influences/"/>
    <id>https://www.duyidong.com/2018/08/07/influences/</id>
    <published>2018-08-07T21:26:35.000Z</published>
    <updated>2018-08-08T14:08:43.000Z</updated>
    
    <content type="html"><![CDATA[<p>在海边和同事闲聊，谈到父辈为何如此喜欢拍照：我父亲喜欢旅游，每到一个地方都要到景点拍照。同事的父亲参加他孩子的毕业典礼全程在用相机记录，“他根本没有在看我女儿，而是一直在盯着他那个小屏幕。”  Phil 这样说。</p><a id="more"></a><p>这让我想起了前两天看到的一组数据，大意是说 90 比 00 后更宅，体现在 90 后花在上网上的时间多于 00 后，交友方式上 90 后更倾向于线上社交而  00 后是线上加线下。这和我们预测的不一样，我们原本以为人们会越来越多的把时间花到网络上甚至分秒不离。回到十年前，很多人担心孩子沉迷网络，而现在“网瘾少年”这个词越来越少被提及，父母成了每天捧着手机上网的人，凡事都由”大数据“来决定，孩子反而偏爱更多类型的活动，有更多独立思考的空间。</p><p>我认为以上两个现象都是<strong>变化</strong>所致。</p><p>父母喜欢拍照是因为相机对于他们那个年龄的人来说是一个新鲜的东西（从无到有是一种变化），在有相机之前他们从来不能“记录”他们觉得珍贵的东西，所以当他们获得了这种能力就会对此爱不释手，而我们出生在一个相机早已存在的年代，相机对我们来说和其他事物一样没什么特别，当然也就不会引起我们更多的注意。而对于互联网，我们这一代人（90后），相信很多人都还记得第一次用线上聊天软件和不知道远在哪里的陌生人开始沟通的那种兴奋，所以对我们来说互联网也是一个从无到有的东西，因此得到了我们的偏爱；而 00 后生在一个已有互联网的时代，互联网对他们来说是一种从出生就“已经存在”的东西，在他们眼中也能得到更加平等的待遇，互联网可以和其他同样存在的东西（比如运动、画画、音乐）做比较，甚至也能和谐共处。</p><p><strong>变化</strong>是个很微妙的东西，变化相对于存在，就如“动”相对于“静”。学电影的时候老师教我们要记录生活里 5% 的有趣和 5% 的悲伤而忘却那 90% 的平庸，这 10% 讲的都是冲突（变化）：例如一个人做早饭，吃早饭，上班，这没什么特别的；而一个人准备做早饭的时候，突然有陌生人来敲门，带来了他父亲去世的消息，这就有了打破常规的东西，有了“变化”，也就是所谓的“转折”，一下就有了代入感，观众会开始思考，为什么他的父亲会去世？这个陌生人和他父亲是什么关系？</p><p><strong>变化</strong>在各个维度都存在。比如特权，在一个人人都写信交流的群落里，少部分人开始用起来手机，就好比这部分人就拥有了特权，人人都羡慕他们。可是当每个人都用上了手机，我们又觉得手机剥夺了我们太多的时间，因为问候变得容易反而拉远了人与人之间的距离，手机变成了想丢也丢不掉的东西。因此大部分人喜欢特权并不是因为特权本身很好，而是因为有的人比别人“多”拥有了特权。这里我们可以把”特权“理解为<u>同一时间同一地点不同个体</u>的变化。</p><p>地理上，居住在内陆的人不会觉得陆地有什么新奇，大海上漂泊的人容易对大海感到厌倦，但是很少听说谁不喜欢海滩，因为这里是海陆相接的地方，是“变化的点”。没有人喜欢永远待在沙漠里，也没有人会乐于定居在戈壁和红红的火山岩上，但是我们会去这些地方旅游，因为他们是“特别的”，这里我们可以理解为<u>同一时间同一个体不同地点</u>的变化。</p><p>这段时间常常待在海边，一阵阵海浪总让我想起 VCD 里面的歌手喜欢用海浪作为 MV 的素材。在<u>同一地点同一个体不同时间</u>上对“变化”的诠释莫过于 30 年前的中国，那是中国人的黄金年代，从农村到城市，从四川到深圳，从深圳到香港，人们开办工厂，下海经商，被压抑已久的激情迸发出来，很多普通人第一次有了自己的想法，一部分人开始为之努力，更小的一部分人成功了，一部分人失败了却收获了经历。那个年代的歌曲充斥着“理想”，“思乡”，和”远方”，能听到怒吼，质问，和没有回答；电影上演的都是有关奋斗，沉沦和人性的思考。对我而言，那是父辈的年代，是一个充满变化的年代，与年轻的荷尔蒙碰撞，产生了各种激动人心的故事，也孕育了 21 世纪这帮追逐机遇的人们。</p><p>然而变化是短暂的，变化的产物，就是<strong>存在</strong>。古代皇帝都有这个经验，打江山容易坐江山难，现在的人也会感叹，创业容易，坚守太难。变化过后，经历过经济发展大潮的人们开始焦虑，焦虑社会阶级固化，焦虑自己能否持续”成长“。这是是“呐喊”过后的“彷徨”，是”变化“产生的惯性和连锁反应，是社会价值观变得单一之后物极必反的结果，以前人人都在为经济发展努力，那么现在的问题是经济发展之后呢？我们如何发展自己的文化？甚至是如何重建自己的文化？思考的过程，比事情正在发生要痛苦很多。</p><p>我承认一代人因为相同的时代背景会有一些相似的地方，如果文章开头提到的数据属实，那么可以认为在平静中成长起来的 00 后，比变化中成长起来的 90 后更适应今天这个”存在”的生活，能做更多想做的事情，能活得更开心，活得更好。但存在必然是会被下一个变化打破，就如浪花交织产生的泡沫，变化意味着机会，如果我们能在变化中找到规律，看到变化后的新格局，为新机会的到来早做准备，就能活得更有目标些。如果我们忘记变化，接受“存在”，或许会活得更轻松些。</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;在海边和同事闲聊，谈到父辈为何如此喜欢拍照：我父亲喜欢旅游，每到一个地方都要到景点拍照。同事的父亲参加他孩子的毕业典礼全程在用相机记录，“他根本没有在看我女儿，而是一直在盯着他那个小屏幕。”  Phil 这样说。&lt;/p&gt;
    
    </summary>
    
      <category term="我的博客" scheme="https://www.duyidong.com/categories/%E6%88%91%E7%9A%84%E5%8D%9A%E5%AE%A2/"/>
    
    
      <category term="闲言碎语" scheme="https://www.duyidong.com/tags/%E9%97%B2%E8%A8%80%E7%A2%8E%E8%AF%AD/"/>
    
  </entry>
  
  <entry>
    <title>再谈 DevOps</title>
    <link href="https://www.duyidong.com/2018/07/28/Let-s-talk-DevOps-job-titles/"/>
    <id>https://www.duyidong.com/2018/07/28/Let-s-talk-DevOps-job-titles/</id>
    <published>2018-07-28T07:19:31.000Z</published>
    <updated>2018-07-30T06:57:22.000Z</updated>
    
    <content type="html"><![CDATA[<p>最近在北美市场掀起一阵平台化的热潮，IT 公司基本上在按照”自动化工具集-&gt;DevOps平台-&gt;数据化平台-&gt; AI 平台“的思路向前演进。加上 k8s 和各种 CloudNative 工具推波助澜，在今年 DevOps 似乎仍是一个热度不减的次词汇。</p><a id="more"></a><p>这时我看到了阮一峰老师提到的<a href="https://mattouille.com/articles/2018-06/lets-talk-devops-job-titles" target="_blank" rel="noopener">Let’s talk DevOps job titles</a>， 将  DevOps 分为”运维、发布管理、平台工程“，觉得是介于”DevOps is next generation of Operators“ 和 ”DevOps is everything“ 之间的一个理解，和我们的实践相差不大，而且易于理解，遂决定一译。我并不打算完全还原作者的意图，一些地方加入了我自己的观点。以下为正文：</p><p>这些年来 DevOps 社区一直为 DevOps 职责的定义争论不休，DevOps 作为一种哲学将是永远高于现在企业应用到 DevOps 的三个关键词：运维、平台工程，和发布管理。</p><h2 id="Google-的-SRE-工程师"><a href="#Google-的-SRE-工程师" class="headerlink" title="Google 的 SRE 工程师"></a>Google 的 SRE 工程师</h2><p>为了简单的解释 DevOps 和运维之间的区别我想在开始引入 Google 的 SRE(Site Reliability Engineering, 站点可用工程)进行阐明。如果你有读过Google的 <a href="https://landing.google.com/sre/book.html" target="_blank" rel="noopener">SRE 系列书</a> 就一定会知道 SRE 是 Google 对运维的一套实践，这是最简单的从开发视角看待运维的解释。</p><p>如果你在做运维之前做过开发，或许你会发现 Google 所提倡的 SRE 和你现在做的运维没多大区别，但不幸的是这个世界上大部分公司不是在按这个方式工作，开发和运维之间是有壁垒的，这也是为什么很多人在听到 DevOps 的时候有如梦初醒的感觉。</p><p>但 SRE 也并不代表软件工程师比系统工程师更擅长解决分布式架构中的基础设施问题。但 SRE 意味着系统工程师必须学会以软件工程师的方式和从软件开发流程上解决问题。</p><p>如此一来，SRE 就和传统运维的脚本作业产生了差别，系统工程师需要了解软件层级的知识以更好地服务于产品。对企业而言，你并不需要一个资深的软件工程师，但是你需要一个有能力构建和改进流程，将运维技能服务化的工程师。</p><p>Amazon 和 Facebook 也有着和 SRE 类似的职位，然而他们对于这个职位的定义和 SRE 却是不一致，我认为 SRE 的定义是比较准确的。</p><h2 id="运维"><a href="#运维" class="headerlink" title="运维"></a>运维</h2><p>众所周知，运维领域正在经历一次革新，云时代带来的变革让传统运维发生巨大的转变，运维不能只在是写写脚本就能解决问题，同时还需要精通各种工具和软件架构。但这也并不就是说所有公司都要开始寻找 SRE 这样的人才，也不是所有公司都需要。</p><p>更多的公司是在找寻熟知CICD(Continues Integration, Continues Devlivery，持续集成与持续交付)这样的工程师，他们熟悉一些操作系统命令，能够帮助企业解决日常问题。但随着软件复杂性越来越高，我不确定这样的模式还会持续多久。</p><h2 id="平台工程"><a href="#平台工程" class="headerlink" title="平台工程"></a>平台工程</h2><p>Platform 和 Cloud 的定义很接近，但并不完全一致。Platform 相比于 Cloud 拥有更高的定制化。</p><p>您可能会问什么是平台？答案是它是在虚拟机或容器上运行软件（如服务发现，网络，工件存储，数据存储等）的基础结构的组合。有一些预建的堆栈，如HashiStack，SaltStack，VMWare，OpenStack，Pivotal Cloud Foundry，Nginx都有自己的，最后最后少不了 Kubernetes。</p><p>它归结为为开发人员提供抽象资源来部署他们的产品，同时需要只适当的基础架构知识就可以管理。平台是将基础设施抽象化后的产品，就像软件一样，由基础设施和代码组成，将流程粘合在一起。</p><h2 id="发布管理"><a href="#发布管理" class="headerlink" title="发布管理"></a>发布管理</h2><p>之所以在这里去去掉了”工程“这个词语，是因为发布管理不是那么工程化的一个实践。</p><p>发布管理非常重要，随着敏捷的普及大多数公司经常会出现一天有多个产品在同时上线的情况，也是公司在变得规模化的途中所必定经历的一个变化。</p><p>做一个好的发布管理，你必须精通 CICD和软件发布流程，不仅要考虑到系统之间的依赖，还要考虑到团队之间的协作。一些公司有专门的团队编写流水线供别的团队使用，我认为这是一种反模式，发布流程应该由各个团队自己掌握同时能做到资源共享，平台化就是一个不错的选择。各个团队有自己 way of working 也很重要。</p><h2 id="结论"><a href="#结论" class="headerlink" title="结论"></a>结论</h2><p>关于 DevOps 有很大程度上与软件部分相关的内容我在文中并没有涉及，因为我认为这部分相关内容并无多少争议。我的目标是让大家对 DevOps 有一个比较一致的认识，我们可以在共同的上下文里讨论兴趣、技术和标准。</p><h2 id="我最近的一些想法"><a href="#我最近的一些想法" class="headerlink" title="我最近的一些想法"></a>我最近的一些想法</h2><p>从 DevOps 的历史来看，DevOps 的缘起就是要讲敏捷推广到运维，后来和微服务、容器化、云等技术呼应，运维变得越来越简单，团队的目标逐渐由技术指标提高到了”我们要更关注产品和产品的制作流程“，我是很赞同这个观点的。不管是软件开发还是运维、运营，你可能要学习很多知识，这些知识包含各种标准、各种协议、各种框架、各种语言、各种工具，但最终目的是为了解决某个问题，让公司从中获利。我们强调速度、强调质量、强调开发者体验的同时都不能忘了这个目的。</p><p>我最近工作的一个团队很有意思，每天早上起来第一件事是看报表，昨天有多少用户来了，干了些什么，哪些人遇到了退订了我们的产品，是什么原因。这些信息让我看到了一个有生命的产品，它是如何和这个时间交互，如何成长，而不是闭门造车似的实现甲方提出的需求。同时这是一个大公司里的小团队，因为人数很少没有角色划分，负责开发某一个功能，不管是弄挂了测试还是网关给 block 住了都是自己解决，和业务人员结对写需求和做用户验收测试，一张卡做完提交到主干分支马上上线。这种方式非常高效，既保证了大公司的流程制度，又有了创业公司的效率，有时间可以展开来写一写。</p>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;最近在北美市场掀起一阵平台化的热潮，IT 公司基本上在按照”自动化工具集-&amp;gt;DevOps平台-&amp;gt;数据化平台-&amp;gt; AI 平台“的思路向前演进。加上 k8s 和各种 CloudNative 工具推波助澜，在今年 DevOps 似乎仍是一个热度不减的次词汇。&lt;/p&gt;
    
    </summary>
    
      <category term="DevOps" scheme="https://www.duyidong.com/categories/DevOps/"/>
    
    
      <category term="翻译" scheme="https://www.duyidong.com/tags/%E7%BF%BB%E8%AF%91/"/>
    
      <category term="DevOps" scheme="https://www.duyidong.com/tags/DevOps/"/>
    
      <category term="Platform" scheme="https://www.duyidong.com/tags/Platform/"/>
    
  </entry>
  
  <entry>
    <title>领域驱动设计（DDD）实践</title>
    <link href="https://www.duyidong.com/2018/04/23/ddd-key-words/"/>
    <id>https://www.duyidong.com/2018/04/23/ddd-key-words/</id>
    <published>2018-04-24T02:49:36.000Z</published>
    <updated>2019-02-24T14:58:08.413Z</updated>
    
    <content type="html"><![CDATA[<p>DDD（Domain Driven Design, 领域驱动设计）是一套原则、约束和方法。广义上的 DDD 是为了解决解决跨部门间语言沟通问题，在业务、产品、开发之间建立领域通用语言（Ubiquitous Language）以提高沟通效率。落地到开发团队，DDD 可以指导我们进行架构设计、团队划分、拆分微服务、乃至代码层面的设计。主要解决系统无法随业务演变而演变的问题。</p><p>DDD 的战术设计体现：</p><pre><code class="java">// BadList&lt;Item&gt; items = order.getItems();items.remove(item);// Goodorder.removeItem(item);</code></pre><h1 id="为什么要-DDD"><a href="#为什么要-DDD" class="headerlink" title="为什么要 DDD"></a>为什么要 DDD</h1><p>传统的设计模式中，不管是 <a href="http://www.ruanyifeng.com/blog/2015/02/mvcmvp_mvvm.html" target="_blank" rel="noopener">MVC，MVP，还是 MVVM</a> 本质上都是数据驱动的。核心上基于<code>M</code>推送消息，<code>V</code>或<code>P</code>来订阅 这个模型。使用者需要维护的不再是 UI 树，而是抽象的数据。(通过数据，可以随时构建出新的 UI 树) ，这种设计在短时间内可以灵活地应对 UI 的变化，但是对于更为复杂的业务变化（比如数据结构的变化），就需要在各个模块都进行修改，修改的内容分散、影响面广、风险大，长此以往，原本架构清晰的系统随着迭代的不断演化，业务逻辑变得越来越复杂，我们的系统也越来越冗杂。模块彼此关联，谁都很难说清模块的具体功能意图是啥。修改一个功能时，往往光回溯该功能需要的修改点就需要很长时间，更别提修改带来的不可预知的影响面。</p><p><img src="https://tech.meituan.com/img/ddd-in-practice/%E6%9C%8D%E5%8A%A1%E8%80%A6%E5%90%88.svg" alt=""></p><center><strong>一个常见的系统耦合病例（图片来自：<a href="https://tech.meituan.com/DDD%20in%20practice.html" target="_blank" rel="noopener">领域驱动设计在互联网业务开发中的实践</a>）</strong></center><p>之所以产生这种现象，归根到底在于随着业务的变化系统架构变得不清晰，划分出来的模块内聚度低、高耦合。理想情况下，如果我们的代码逻辑按照业务结构来组织，代码架构就可以随着业务的变化变化，这样代码就会变得易于维护；由于要去阅读代码的人首先需要具备领域知识，代码又是对业务的直接呈现，代码的可读性也会极大提高。</p><p>任何一种理念的落地都不是一蹴而就的，我下面从战术设计和代码实践的角度，围绕一个案例探讨一下 DDD 的几个核心概念。</p><h1 id="六边形架构（Hexagonal-Architecture）"><a href="#六边形架构（Hexagonal-Architecture）" class="headerlink" title="六边形架构（Hexagonal Architecture）"></a>六边形架构（Hexagonal Architecture）</h1><p>六边形架构（Hexagonal Architecture），又称为<strong>端口和适配器</strong>风格，最早由<a href="http://alistair.cockburn.us/Hexagonal+architecture" target="_blank" rel="noopener">Alistair Cockburn</a>提出。在DDD社区得到了发展和推广，之所以是六变形是为了突显这是个扁平的架构，每个边界的权重是相等的。</p><p>我们知道，经典分层架构分为三层（展现层、应用层、数据访问层），而对于六边形架构，可以分成另外的三层：</p><ul><li><strong>领域层</strong>（Domain Layer）：最里面，纯粹的核心业务逻辑，一般不包含任何技术实现或引用。</li><li><strong>端口层</strong>（Ports Layer）：领域层之外，负责接收与用例相关的所有请求，这些请求负责在领域层中协调工作。端口层在端口内部作为领域层的边界，在端口外部则扮演了外部实体的角色。</li><li><strong>适配器层</strong>（Adapters Layer）：端口层之外，负责以某种格式接收输入、及产生输出。比如，对于 HTTP 用户请求，适配器会将转换为对领域层的调用，并将领域层传回的响应进行封送，通过 HTTP 传回调用客户端。在适配器层不存在领域逻辑，它的唯一职责就是在外部世界与领域层之间进行技术性的转换。适配器能够与端口的某个协议相关联并使用该端口，多个适配器可以使用同一个端口，在切换到某种新的用户界面时，可以让新界面与老界面同时使用相同的端口。</li></ul><p>这样做的好处是将使业务边界更加清晰，从而获得更好的扩展性，除此之外，<strong>业务复杂度和技术复杂度分离</strong>，是 DDD 的重要基础，核心的领域层可以专注在业务逻辑而不用理会技术依赖，外部接口在被消费者调用的时候也不用去关心业务内部是如何实现。</p><p><img src="https://image.slidesharecdn.com/javadev-hexagonalarchitectureforjavaapplications-150202062634-conversion-gate01/95/hexagonal-architecture-for-java-applications-10-638.jpg?cb=1423245064" alt=""></p><center><strong>图片来自：<a href="https://www.slideshare.net/fabricioepa/hexagonal-architecture-for-java-applications" target="_blank" rel="noopener">Hexagonal architecture for java applications</a></strong></center><p>正如上文提到，六边形架构的出现早于 DDD，要实现 DDD 也不是非要采用六边形架构，只是这种架构正好契合了 DDD 所需的条件，从六边形架构出发，可以更容易理解 DDD 的思想。如上图所示， Adapter 所在的绿色线框表示<strong>限界上下文</strong>，中间橙色的六边形表就是<strong>应用服务</strong>，标记出核心领域模型对外暴露的功能和方法。Application 所在的核心就是<strong>领域模型</strong>，包含<strong>领域对象</strong>和<strong>领域服务</strong>，其中领域对象又分为<strong>实体对象</strong>和<strong>值对象</strong>，值对象中的一个特定对象就是<strong>聚合根</strong>，聚合根就是这个领域的核心。</p><p>落实到代码层面，也可以用分层架构来理解，DDD 架构从上到下可以分为四层：</p><ul><li><p><strong>用户界面层（或表示层）</strong><br>负责向用户显示信息和解释用户指令，这里指的用户可以是另一个系统，不一定是使用用户界面的人。</p></li><li><p><strong>应用层</strong><br>定义软件要完成的任务，并且指挥表达领域概念的对象来解决问题。应用层要尽量简单，不包含业务规则或者知识，而只为下一层中的领域对象协调任务，分配工作，使他们相互协作，他没有反应业务情况的状态，但是却可以具有另一种状态，为用户或程序显示某个任务的进度。</p></li><li><p><strong>领域层（或模型层）</strong><br>负责表达业务概念，业务状态信息以及业务规则。尽管保存业务状态的技术细节是由基础设施层实现的，但是反应业务情况的状态是由本层控制并且使用的。<strong>领域层是业务软件的核心。</strong></p></li><li><p><strong>基础设施层</strong><br>为上面两层提供通用的技术能力：为应用层传递消息，为领域层提供持久化机制，等等。</p></li></ul><p><img src="https://tech.meituan.com/img/ddd-in-practice/DDD-%E5%88%86%E5%B1%82.svg" alt=""></p><center><strong>图片来源：<a href="https://tech.meituan.com/DDD%20in%20practice.html" target="_blank" rel="noopener">美团点评技术团队</a></strong></center><h1 id="限界上下文（Bounded-Context）"><a href="#限界上下文（Bounded-Context）" class="headerlink" title="限界上下文（Bounded Context）"></a>限界上下文（Bounded Context）</h1><p>限界上下文大部分情况下被划入战略设计的范畴，可以用于指导拆分代码库、部署单元、微服务甚至团队。</p><p>限界的意思是划定边界，边界内部的领域逻辑应该有尽可能少的交集；上下文的意思就是语境，即特定的对象在特定的语境下的模型是不同的，例如轮胎这个对象在修理汽车这个上下文中，其模型只需要包含品牌、型号两种属性，而在出售汽车轮胎的上下文中的模型还应该包含制造厂商、价格的属性。</p><p><strong>边界通过限界上下文来确定，这在领域驱动设计中具有非凡的意义。</strong>对应于通用语言，限界上下文是语言的边界，对于领域模型，限界上下文是模型的边界，二者对应于问题空间（Problem Space）的界定。对于系统的架构，限界上下文还确定了应用边界和技术边界，进而帮助我们确定整个系统及各个限界上下文的解决方案。可以说，限界上下文是连接问题空间与解决方案空间的重要桥梁。</p><h1 id="应用服务（Application-Service）"><a href="#应用服务（Application-Service）" class="headerlink" title="应用服务（Application Service）"></a>应用服务（Application Service）</h1><p>应用服务是用来<strong>表达用例和用户故事（User Story)</strong>的主要手段。</p><p>应用层通过应用服务接口来暴露系统的全部功能。在应用服务的实现中，它负责<strong>编排和转发</strong>，它将要实现的功能委托给一个或多个领域对象、领域服务、和资源库来实现，它本身只负责处理业务用例的执行顺序以及结果的拼装。</p><p>应用层相对来说是较“薄”的一层，除了定义应用服务之外，在该层我们可以进行安全认证，权限校验，持久化事务控制，或者向其他系统发生基于事件的消息通知。</p><p>应用层作为展现层与领域层的桥梁。展现层使用VO（视图模型）进行界面展示，与应用层通过DTO（数据传输对象）进行数据交互，从而达到展现层与DO（领域对象）解耦的目的。一个应用服务应该包含以下功能和特点：</p><ul><li>处理基本数据类型</li><li>向外暴露业务能力</li><li>不包含业务逻辑</li><li>对应业务用例（非CRUD）</li><li>组织协调</li><li>事务边界</li><li>日志</li><li>一层而非一个对象</li></ul><p>一个理想的 Service 应该包含四个动作：<code>get</code>、<code>update</code>、<code>save</code>，举个例子，用户初始化密码的一个事件：</p><pre><code class="java">    public void initialPassword(SetPasswordCommand command) {        User user = userRepository.findByUuid(command.getUuid()).orElseThrow(UserNotExistException::new); // 获得 User        user.setPassWord(command.getPassword());                                      // 更新 User        logger.info(&quot;Set password with uuid[{}]&quot;, command.getUuid());                 // 日志        userRepository.save(user);                                                    // 持久化 User    }</code></pre><p>除了对领域对象的操作，ApplicationService 还会承担解构技术数据为业务数据（划分领域边界）、日志（反应业务状态）的功能。</p><p>有时候业务逻辑的处理会比较复杂，以创建用户为例，最好使用构造函数处理，但如果面临比较复杂的场景，比如还需要对用户输入的信息进行验证，就可以使用一个工厂类来创建我的领域对象，这个时候这个工厂类就是一个领域服务，所有核心业务逻辑都应该在领域服务中，而不要在 ApplicationService 层：</p><pre><code class="java">    public String register(RegistrationCommand command) {        User user = registerService.createUser(command.getOwnerEmail(), command.getPolicyNumber());                                                           // 调用 RegisterService 执行创建 User 的动作，业务相关验证也在 RegisterService 里面        logger.info(&quot;Create user with email [{}]&quot;, command.getOwnerEmail());          // 日志        return user.getUuid();                                                        // 返回业务需要的 ID    }</code></pre><h1 id="领域模型（Domain-Model）"><a href="#领域模型（Domain-Model）" class="headerlink" title="领域模型（Domain Model）"></a>领域模型（Domain Model）</h1><p>领域模型是业务代码所在区域，也是服务的核心所在，领域模型分为领域对象和领域服务两大类，领域对象用于存储状态，领域服务用于改变领域对象的状态。</p><h2 id="领域服务（Domain-Service）"><a href="#领域服务（Domain-Service）" class="headerlink" title="领域服务（Domain Service）"></a>领域服务（Domain Service）</h2><p>领域层就是较“胖”的一层，因为它实现了全部业务逻辑并且通过各种校验手段保证业务正确性。而什么是业务逻辑呢？业务流程、业务策略、业务规则、完整性约束等。</p><blockquote><p>当领域中的某个操作过程或转换过程不是实体或值对象的职责时，我们便应该将该操作放在一个单独的接口中，即领域服务。请确保该服务和通用语言时一致的；并且保证它是无状态的。</p></blockquote><h3 id="领域服务无状态怎么理解？"><a href="#领域服务无状态怎么理解？" class="headerlink" title="领域服务无状态怎么理解？"></a>领域服务无状态怎么理解？</h3><p>领域服务是用来协调领域对象完成某个操作，用来处理业务逻辑的，它本身是一个行为，所以是无状态的。状态由领域对象（具有状态和行为）保存。</p><h3 id="什么时候使用领域服务？"><a href="#什么时候使用领域服务？" class="headerlink" title="什么时候使用领域服务？"></a>什么时候使用领域服务？</h3><p><strong>领域对象是具有状态和行为的。</strong>那就是说我们也可以在实体或值对象来处理业务逻辑。那我们该如何取舍呢？<br>一般来说，在下面的几种情况下，我们可以使用领域服务：</p><ul><li>执行一个显著的业务操作过程</li><li>对领域对象进行转换</li><li>以多个领域对象为输入，返回一个值对象。</li></ul><p>以用户登录为例，登录是一个显著的业务操作过程，因此把它作为一个领域服务，登录需要验证邮箱是否存在，如果存在则进行密码验证，这些属于核心业务逻辑，不应该暴露在ApplicationService 里面，所以 Application Service 里的 login 方法是这样：</p><pre><code class="java">    public boolean login(UserLoginCommand command) {        boolean loginSuccess = loginService.login(command.getEmail(), command.getPassword());        logger.info(&quot;User login with email [{}]&quot;, command.getEmail());        return loginSuccess;    }</code></pre><p>而表达业务含义的核心代码在领域服务 LoginService 里面：</p><pre><code class="java">@Servicepublic class LoginService {    @Autowired    UserRepository userRepository;    public boolean login(String email, String password) {        User user = userRepository.findByEmail(email).orElseThrow(UserNotExistException::new);        Boolean loginSuccess = user.isPassWordCorrect(password);        if(loginSuccess) user.online();        return loginSuccess;    }}</code></pre><p>可以看到领域服务并没有保存登录有关的状态，而是在 User 里记录了 Online，领域服务中也可以调用领域对象的方法完成一些验证、状态更新的操作。</p><p>需要注意的是，领域服务不用特别关心实现细节，只用写业务代码，以创建 Policy 的 PolicyFactoryService 的 createPolicy 为例：</p><pre><code class="java">    public HomePolicy createPolicy(CreateHomePolicyCommand command) {        HomePolicy homePolicy = homePolicyMapper.map(command, HomePolicy.class);        if (!homePolicyQuotationRepository.existsByQuoteId(homePolicy.getQuoteId()))            throw new InvalidQuotationException();        homePolicyRepository.save(homePolicy);        return homePolicy;    }</code></pre><p>homePolicy.map 是一个技术动作，就不宜出现在领域服务中，这里用构造方法代替会更好，map 这类数据类型转换的动作可以放到 ApplicationService 中。</p><h2 id="领域对象（Domain-Object）"><a href="#领域对象（Domain-Object）" class="headerlink" title="领域对象（Domain Object）"></a>领域对象（Domain Object）</h2><p>领域对象有分为<strong>实体对象</strong>和<strong>值对象</strong>，<strong>实体对象</strong>是具有生命周期，有唯一标示，可以通过 ID 判断相等性，有增删改查操作，可记录状态的一些对象，比如 Policy，User。如下是一个”贫血的领域对象“，之所以说它是领域对象是因为它有唯一标示，之所以它贫血是因为它没有业务动作。</p><pre><code class="java">@Getter@Setter@Entity@Inheritance(strategy = InheritanceType.JOINED)@Table(name = &quot;POLICY&quot;)public class Policy {    @Id    private String policyNumber = UUID.randomUUID().toString();    private LocalDate startDate;    private String quoteId;    @Embedded    @AttributeOverrides(value = {            @AttributeOverride(name = &quot;id&quot;, column = @Column(name = &quot;policy_holder_id&quot;)),            @AttributeOverride(name = &quot;name&quot;, column = @Column(name = &quot;policy_holder_name&quot;)),            @AttributeOverride(name = &quot;email&quot;, column = @Column(name = &quot;policy_holder_email&quot;)),            @AttributeOverride(name = &quot;birthDay&quot;, column = @Column(name = &quot;policy_holder_birthday&quot;))    })    private PolicyHolder policyHolder;}</code></pre><p>由于 Policy 只需要被创建，所以它并不包含改变自身状态的方法，但所有业务上对 Policy 会有的操作都已经包含在了这个领域对象中，所以它还是一个<strong>聚合根</strong>。</p><p><strong>值对象</strong>是指起描述作用，无唯一标识，只能通过属性判断是否相等，即时创建，用完即回收的不可变对象，例如 Policy 的子属性 PolicyHolder：</p><pre><code class="java">@Getter@Setter@Embeddablepublic class PolicyHolder {    private String id;    private String name;    private String email;    private LocalDate birthDay;}</code></pre><p>它只是作为 Policy 的一个成员类，不能有自己的动作，所有对 PolicyHolder 的操作必须通过<strong>聚合根</strong> Policy 来进行，对于一个 Policy 而言，要换 PolicyHolder 的话要重新实例化一个 PolicyHolder，所以这个地方他只是个值对象，他的持久化依赖于聚合根 Policy。</p><pre><code class="java">// BadPolicyHolder oldHolder = Policy.getHolder();oldHolder.update(newHolder);// GoodPolicy.updateHolder(newHolder);</code></pre><p>现在你应该很清楚文章开头那里例子了吧，第二种实现屏蔽了 Policy 里的结构细节，我只需要知道我更新了 Holder 就可以，至于如何更新的并不需要关心。</p><h2 id="聚合根（Aggregate-Root）"><a href="#聚合根（Aggregate-Root）" class="headerlink" title="聚合根（Aggregate Root）"></a>聚合根（Aggregate Root）</h2><p>在领域对象的部分已经谈到了聚合根，聚合根属于实体对象，它是领域对象中一个高度内聚的核心对象。<strong>一个领域内的数据一致性由聚合根保证，聚合根之间的数据一致性就要通过最终一致性来完成。</strong></p><p>聚合根可以被应用服务直接调用，如在 initialPassword 方法中调用</p><pre><code class="java">user.setPassWord(command.getPassword());</code></pre><p>或者领域对象的构造方法。</p><p>聚合根也可以在领域服务里被调用，如在 <code>LoginServer</code>里调用</p><pre><code class="java">user.isPassWordCorrect(password);</code></pre><h1 id="资源库（Repository）"><a href="#资源库（Repository）" class="headerlink" title="资源库（Repository）"></a>资源库（Repository）</h1><p>理想情况下一个实体对象的生命周期开始于一个 Factory，终止于 Repository 。</p><p>资源库是生命周期的结束，它封装了基础设施以提供查询和持久化聚合的操作。这样能够让我们始终聚焦于模型，而把对象的存储和访问都委托给资源库来完成。需要注意的是，资源库并不是数据库的封装，而是领域层与基础设施之间的桥梁。DDD关心的是领域内的模型，而并非是数据库的操作。理想的资源库对客户（领域服务和应用服务）隐藏了内部的工作细节，委托基础设施层来干那些脏活，到关系型数据库、NOSQL、甚至内存里读取和存储数据。因此资源库有以下两个特性：</p><ul><li>可插拔性</li><li>聚合根的集合</li></ul><p>仓储的要点并不是使代码更容易测试，也不是为了便于切换底层的持久化存储方式。当然，在某种程度上，这也的确是仓储所带来的利好。<strong>仓储的要点是保持你的领域模型和技术持久化框架的独立性，这样你的领域模型可以隔离来自底层持久化技术的影响</strong>。如果没有仓储这一层，你的持久化基础设施可能会泄露到领域模型中，并影响领域模型完整性和最终一致性。</p><p><img src="/images/ddd_layer_architecture.png" alt=""></p><center><strong>图：DDD 分层架构</strong></center><p>如图所示，应用服务层不必关心技术层返回使用何种标准，只作为领域模型对外暴露接口的服务。在领域模型中有领域服务、聚合根两种模块，业务操作通过领域服务改变聚合根状态实现，状态持久化通过资源库调用底层数据库实现，同样，资源库的调用者也不需要担心持久化的技术细节，需要何种数据库、如何进行存储，都交给 Repository 的内部实现来做。图中的箭头表示的是“领域事件”。</p><h1 id="领域事件（Domain-Event）"><a href="#领域事件（Domain-Event）" class="headerlink" title="领域事件（Domain Event）"></a>领域事件（Domain Event）</h1><blockquote><p>用例-应用服务-聚合根-事务</p></blockquote><p>领域事件应该对应到聚合根上的一个操作，承担了<strong>记录业务活动</strong>、<strong>解耦限界上下文</strong>、<strong>保证最终一致性</strong>三个重要的责任；可以由应用服务或者资源库发布。他有两个重要的特性：<strong>幂等性</strong>和<strong>原子性</strong>：</p><ul><li><strong>幂等性</strong>：消费方接受多条 event 和接受一条是结果是一样的。这是由于以 MQ 为例，为了保证最终一致性往往会重复发送同一个事件，这个时候接受方就要进行处理，保证不会出现错误或是冗余的数据。</li><li><strong>原子性</strong>：虽然在不同聚合根之间我们采用了基于领域事件的最终一致性，但是在业务操作和事件发布之间我们依然需要采用强一致性，也即这两者的发生应该是原子的，要么全部成功，要么全部失败，否则最终一致性根本无从谈起。</li></ul><h1 id="后记"><a href="#后记" class="headerlink" title="后记"></a>后记</h1><p>DDD 是一种思想，采用 DDD 并不是要一次全盘接受他的所有实践，好的实践需要加以时间打磨，适合业务和团队的才是最好的。</p><p>文中提到的代码，完整版在这里：<a href="https://github.com/ADU-21/ddd_demo" target="_blank" rel="noopener">https://github.com/ADU-21/ddd_demo</a></p><blockquote><ul><li><strong>References:</strong></li><li><a href="https://www.cnblogs.com/netfocus/archive/2011/10/10/2204949.html" target="_blank" rel="noopener">https://www.cnblogs.com/netfocus/archive/2011/10/10/2204949.html</a></li><li><a href="https://tech.meituan.com/DDD%20in%20practice.html" target="_blank" rel="noopener">https://tech.meituan.com/DDD%20in%20practice.html</a></li><li><a href="https://insights.thoughtworks.cn/from-sandwich-to-hexagon/" target="_blank" rel="noopener">https://insights.thoughtworks.cn/from-sandwich-to-hexagon/</a></li><li><a href="http://www.cnblogs.com/xishuai/p/iddd-soa-rest-and-hexagonal-architecture.html" target="_blank" rel="noopener">http://www.cnblogs.com/xishuai/p/iddd-soa-rest-and-hexagonal-architecture.html</a></li><li><a href="http://www.cnblogs.com/sheng-jie/p/7097129.html" target="_blank" rel="noopener">http://www.cnblogs.com/sheng-jie/p/7097129.html</a></li><li><a href="http://qinghua.github.io/ddd/" target="_blank" rel="noopener">http://qinghua.github.io/ddd/</a></li></ul></blockquote>]]></content>
    
    <summary type="html">


        &lt;p&gt;DDD（Domain Driven Design, 领域驱动设计）是一套原则、约束和方法。广义上的 DDD 是为了解决解决跨部门间语言沟通问题，在业务、产品、开发之间建立领域通用语言（Ubiquitous Language）以提高沟通效率。落地到开发团队，DDD 可以指导我
      
    
    </summary>
    
      <category term="Java" scheme="https://www.duyidong.com/categories/Java/"/>
    
    
      <category term="Java" scheme="https://www.duyidong.com/tags/Java/"/>
    
      <category term="DDD" scheme="https://www.duyidong.com/tags/DDD/"/>
    
      <category term="架构" scheme="https://www.duyidong.com/tags/%E6%9E%B6%E6%9E%84/"/>
    
      <category term="设计" scheme="https://www.duyidong.com/tags/%E8%AE%BE%E8%AE%A1/"/>
    
  </entry>
  
  <entry>
    <title>被动语态与常用句式</title>
    <link href="https://www.duyidong.com/2018/04/05/english-passive-voice/"/>
    <id>https://www.duyidong.com/2018/04/05/english-passive-voice/</id>
    <published>2018-04-06T04:38:54.000Z</published>
    <updated>2018-04-10T08:56:39.000Z</updated>
    
    <content type="html"><![CDATA[<p>有了上文的时态作为铺垫，日常英文交流不得不知的还有表动语态和各种句式，被动语态通常是用在强调动作承受者或者不知道动作施与者是谁的时候；而各种句式主要讲的是如何把简单句组合成表意更完整的句子。</p><h1 id="被动语态"><a href="#被动语态" class="headerlink" title="被动语态"></a>被动语态</h1><blockquote><p> 只有及物动词(vt)才有被动语态，不及物动词（vi）是没有被动语态的。</p></blockquote><p>被动语态按中文讲，就是把“把”字句变成“被”字句，以<code>主谓宾</code>句式为例，大部分情况下是将宾语前置做主语，动词变为过去分词，并在前面加 be 动词（随 16 种时态变化，与原句保持一致），主语省略或在前面加上介词 by 做状语。</p><pre><code>举个例子：I beat him. =&gt; He was beaten./He was beaten by me.</code></pre><p>从例句<code>He was beaten.</code>中可以看出，被动语态其实是一种特殊的<code>主系表</code>句型，过去分词<code>beaten</code>在句中做表语。</p><h2 id="被动语态中的谓语"><a href="#被动语态中的谓语" class="headerlink" title="被动语态中的谓语"></a>被动语态中的谓语</h2><p>谓语是表述含义中的最重要的成分，被动变化规则比较固定，参照<a href="/2018/03/28/English-16-tense/">英文时态详解</a>中的时态表格，下面是 9 种时态下被动语态的一般规则：</p><table><thead><tr><th></th><th>过去</th><th>现在</th><th>将来</th></tr></thead><tbody><tr><td><strong>一般式</strong></td><td><strong>一般过去式</strong><br>was/were + 过去分词</td><td><strong>一般现在式</strong><br>am/is/are + 过去分词</td><td><strong>一般过去式</strong><br>will be + 过去分词</td></tr><tr><td><strong>进行式</strong></td><td><strong>过去进行式</strong><br>was/were being + 过去分词</td><td><strong>现在进行式</strong><br>am/is/are being + 过去分词</td><td><strong>将来进行式</strong><br>will be being + 过去分词</td></tr><tr><td><strong>完成式</strong></td><td><strong>过去完成式</strong><br>had been + 过去分词</td><td><strong>现在完成式</strong><br>have/has been + 过去分词</td><td><strong>将来完成式</strong><br>will have been + 过去分词</td></tr></tbody></table><h2 id="被动语态中的介词"><a href="#被动语态中的介词" class="headerlink" title="被动语态中的介词"></a>被动语态中的介词</h2><p>动词的变化基本就是加上 be 变过去分词，比较好理解，而介词的变化则可能需要花更多的时间培养语感和练习，尤其涉及到一些固定搭配：</p><ul><li>双宾倒置中的介词 to, for, of：<ul><li>表“给予”概念，用 to；表“代劳”概念，要用 for。</li><li><strong>Ask 要用 of：</strong> I asked a question of John.</li><li>Rob, deprive, cure, relieve，是授予动词，但约定与 of 连用：He <u>robbed</u> me <u>of</u> my money</li></ul></li><li>Provide, furnish, supply 表示“提供”的授予动词，但必须与 with 连用：<ul><li>He <u>provided</u> me <u>with</u> a lot of money.</li><li>We supply the three nearby towns <u>with</u> power. </li><li>但宾语倒置时仍然用 to, for: We supply power <u>to</u> the three nearby towns.</li></ul></li><li>Make, have, let, get 这四个使役动词只有 make 可以用于被动语态。<ul><li>They made me review the code -&gt; I was made <u>to</u> review the code.</li></ul></li><li>宾语中出现 be 或者 to be，通常要省略，例如 He get this task to be finished 应该为 He get this task finished，更多例子：<ul><li>This experience makes you (to be) a man.</li><li>The trip made her (be) happy.</li></ul></li><li>认定动词（consider, deem, think, find, believe）动词 + 宾语 + （to be 省略）+ 名词或形容词（补语），认为… 是…<ul><li>I <u>found</u> your advice really useful.</li><li>Our team <u>think</u> this problem determination.</li></ul></li><li>认定动词（regard, look upon, think of, see, view），表示把… 当做… ：动词 + 宾语 + 介词 as + 名词或形容词（补语）<ul><li>In spite of this, the Italians <u>regarded</u> hime <u>as</u> a sort of hero.</li><li>His students all <u>look upon</u> him <u>as</u> a friend.</li><li>They <u>think of</u> themseleves <u>as</u> the salt of the earth.</li><li>I’d like to <u>see</u> Europe <u>as</u> a nuclear-free zone.</li><li>We <u>view</u> every customer <u>as</u> a partner.</li></ul></li></ul><h1 id="祈使句"><a href="#祈使句" class="headerlink" title="祈使句"></a>祈使句</h1><p>英文中的祈使句是非常不客气非常强烈的，为了用英文表达和中文同样的意思，需要加 Would you please … ? 或者 please…</p><p>中文的我想。。也不能翻译成 I want.. 而应该翻译成 I would like …</p><h1 id="复合句（compound-sentence）"><a href="#复合句（compound-sentence）" class="headerlink" title="复合句（compound sentence）"></a>复合句（compound sentence）</h1><blockquote><p>Give me liberty or give me death. 不自由，毋宁死。</p></blockquote><p>复合句，也就是并列句，是指用 and, but, however 这类连词连接句子成分或两个句子，比较常用。以下几个 tips：</p><ul><li>大部分连词，除了 but，前后都是不应该有逗号的，尤其是 and，要注意不要把中文中断句的习惯带到英文中。</li></ul><ul><li>连接句子中如果连接的是两个相同的谓语，则可省略后一个谓语，例：I enjoy the hotpot and you the soup.</li><li>not only… but also… 是美式英语的习惯用法，英式英语习惯使用：not only… but… as well.</li></ul><h1 id="复杂句（complex-sentence）"><a href="#复杂句（complex-sentence）" class="headerlink" title="复杂句（complex sentence）"></a>复杂句（complex sentence）</h1><p>也称从句，比较简单，在句子末尾加上 that, when, which 后面再跟一个句子用于修饰宾语是最常见的用法，句式结构：<strong>复杂句 = 主句 + 从句 = 简单句1 + 引导词 + 简单句2</strong>。容易忽视的一个用法是把  That 作为开头先用一个句子来描述主语：That everyone may receive a moderate education is an object of vital improtance.每个人都能接受教育似乎是个个至关重要的目标。That 作主语从句是为了使句子显得更紧凑，通常用在主语的内容比句子本身更重要的时候，大部分情况下句子本身才是我们要表达的核心观点，只是为了对主语作补充说明，可以用 It 放在句子开头，真正的主语在句末加 that 后置： It was obvious that he was very embarrassed，另外有一些情况是必须用 it 的，在谓语是 consider, deem, think, find, believe 时，例如： I think <u>it</u> important that we should speake English eveyday. 就不能用 that 代替 it, it 后面可以加 be 动词。</p><p>从句有三类：名词从句、定语从句、状语从句。</p><h2 id="名词从句"><a href="#名词从句" class="headerlink" title="名词从句"></a>名词从句</h2><p>一个简单的列子：I’m wondering what <u>you are doing</u>. 划线部分在句子中充当宾语，词性是名词。</p><p>名词可以在句子中充当不同的成分，又可以分为主语从句、宾语从句、表语从句和同位语从句。</p><h2 id="定语从句"><a href="#定语从句" class="headerlink" title="定语从句"></a>定语从句</h2><p>修饰名词的句子成分叫做定语，因此用一句话来修饰一个名词就成了定语从句。</p><p>The man who <u>come from Identity team</u> helped us do the PVT.  （介词 who 可省略）划线部分作为定语修饰 “The man”。</p><h2 id="状语从句"><a href="#状语从句" class="headerlink" title="状语从句"></a>状语从句</h2><p>定语和名词用法比较固定，状语按表述含义类型可划分为以下五大类：</p><ul><li><strong>时间状语从句</strong>：when/while/as, Whenever无论何时, as soon as/ the moment, no sonner… than 刚… 就…（主句动作已完成）, hardly/scarcely…when/before…刚…就… （主句动作未完成）, since/ ever sinece自从</li><li><strong>地点状语从句</strong>： where</li><li><strong>原因状语从句</strong>：because, as, since, for, in, that，注意 because 接从句，because of 后只能接名词</li><li><strong>条件状语从句</strong>：if, unless 引</li><li><strong>比较状语从句</strong>：as…as…, than.. 用法比较灵活</li><li><strong>结果状语从句</strong>： so… that… 如此…以至于… such… that … such 后接名词 that 后是名词从句：He is such a good developer that coding very fast.</li><li><strong>目的状语从句</strong>：so that, in order that, that 以便于…I am saving money in order that I can buy a house.</li><li><strong>让步状语从句</strong>：thought, although, even though, even if。虽然…但是… 与中文不同，主语前面绝不再可加 but，但可用 yet/still。<ul><li>though, although, even though 是对事实的让步，译为“虽然，尽管”</li><li>even if 对假设的让步，译为即使，哪怕是</li><li>while/whereas 也可引导状语从句，相当于 though 或 although</li><li>whether 也可引导让步状语从句，表示“无论…”常和 or 或者 or not 一起使用</li></ul></li><li><strong>方式状语从句</strong>：as, as if, as though, the way 就像…一样，以…样的方式<ul><li>注意：美式英语中常用 like 来代替 as if, as though, 但书面语中少用</li></ul></li></ul><p>在掌握了一些稍微复杂的句式之后，一些像是 Native speaker 才会说的英语短语会为你的英文口语增色不少，附上 ThoughtWorks 同事整理的英文词组集合，很有意思：</p><ul><li><a href="https://starzhou.com/blogs/common_english_phrase" target="_blank" rel="noopener">实用英语词组总结</a></li><li><a href="https://starzhou.com/blogs/common_english_phrase2" target="_blank" rel="noopener">实用英语词组总结（二）</a></li><li><a href="https://starzhou.com/blogs/common_english_phrase3" target="_blank" rel="noopener">实用英语词组总结（三）</a></li><li><a href="https://starzhou.com/blogs/common_english_phrase4" target="_blank" rel="noopener">实用英语词组总结（四）</a></li><li><a href="https://starzhou.com/blogs/how_to_phraze_praise_in_english" target="_blank" rel="noopener">鼓励打鸡汤短语合集</a></li></ul><blockquote><ul><li>References:</li><li><a href="https://baike.baidu.com/item/%E4%BB%8E%E5%8F%A5" target="_blank" rel="noopener">百度百科：从句</a></li><li><a href="https://www.zhihu.com/question/31730389" target="_blank" rel="noopener">知乎：怎样浅显易懂地解释英语各种从句的逻辑？</a></li></ul></blockquote>]]></content>
    
    <summary type="html">


        &lt;p&gt;有了上文的时态作为铺垫，日常英文交流不得不知的还有表动语态和各种句式，被动语态通常是用在强调动作承受者或者不知道动作施与者是谁的时候；而各种句式主要讲的是如何把简单句组合成表意更完整的句子。&lt;/p&gt;
&lt;h1 id=&quot;被动语态&quot;&gt;&lt;a href=&quot;#被动语态&quot; class=&quot;
      
    
    </summary>
    
      <category term="English" scheme="https://www.duyidong.com/categories/English/"/>
    
    
      <category term="学习" scheme="https://www.duyidong.com/tags/%E5%AD%A6%E4%B9%A0/"/>
    
      <category term="英文" scheme="https://www.duyidong.com/tags/%E8%8B%B1%E6%96%87/"/>
    
  </entry>
  
  <entry>
    <title>英文时态详解</title>
    <link href="https://www.duyidong.com/2018/03/28/English-16-tense/"/>
    <id>https://www.duyidong.com/2018/03/28/English-16-tense/</id>
    <published>2018-03-29T06:16:37.000Z</published>
    <updated>2018-03-31T15:36:09.000Z</updated>
    
    <content type="html"><![CDATA[<p>来 ThoughtWorks 两年了，英文使用也两年了，日常和工作中的交流几乎是没有问题，但是在说和写的时候总还觉得不地道，要么太啰嗦，要么说着说着逻辑就乱了，有时甚至感觉说英文像是在堆砌单词。最近补了一下英文语法，发现用错时态是我日常交流中最容易犯的错误，特此组织成文，方便日后查阅。</p><h1 id="时态的定义"><a href="#时态的定义" class="headerlink" title="时态的定义"></a>时态的定义</h1><p>我们已经知道复杂句由简单句构成，简单句有<strong>主系表</strong>、<strong>主谓</strong>、<strong>主谓宾</strong>、<strong>主谓宾宾补</strong>、<strong>主谓宾宾</strong>（授予）五大基本句型。大部分情况下，名词（主语、宾语）由<strong>定语</strong>修饰限定，动词（谓语）由<strong>状语</strong>修饰补充，就构成了日常使用的大部分简单的句子。在简单句的构成上英文和中文并没有太大差别，只是英文句式结构更严谨，表达的内容也不会有太大差异。而之所以英文和中文的学习有很大的差别，时态是一个重要的原因。</p><blockquote><p> 时态就是表示一个动作发生的<strong>时间（tense）</strong>和所处的<strong>状态（aspect）</strong>。</p></blockquote><p>中文的动词侧重表意，也就是描绘动作本身，因此一个动词不管在何种语境下都是同样的说法同样的写法，因为他的含义是一样的；而英文中加入了时态的概念，在动词出现的时候就包含了关于这个动作“时间”和“状态”的信息，这也是为什么说英文描述比中文准确的原因，也是我们培养英语语感必须要迈过的一步。</p><ul><li>“时”就是这个动作发生的“时间”。英语中把时间分为三类：<code>过去</code>、<code>现在</code>和<code>将来</code>。</li><li>“态”就是这个动作在某个时刻的“状态”。动词共有四类状态，分别为：<code>一般式</code>、<code>进行式</code>、<code>完成式</code>和<code>进行完成式</code>。</li></ul><p>把这三个时间四种状态分别作为横轴和纵轴就形成了十二类时态的表格：（<strong>过去将来</strong>这个时间比较抽象，放到最后单独讲）</p><table><thead><tr><th style="text-align:center"></th><th style="text-align:center">过去</th><th style="text-align:center">现在</th><th style="text-align:center">将来</th></tr></thead><tbody><tr><td style="text-align:center">一般式</td><td style="text-align:center">一般过去式<br> did</td><td style="text-align:center">一般现在式<br>do</td><td style="text-align:center">一般过去式<br>will do</td></tr><tr><td style="text-align:center">进行式</td><td style="text-align:center">过去进行式<br>was/were doing</td><td style="text-align:center">现在进行式<br>am/is/are doing</td><td style="text-align:center">将来进行式<br>will be doing</td></tr><tr><td style="text-align:center">完成式</td><td style="text-align:center">过去完成式<br>had done</td><td style="text-align:center">现在完成式<br>have/has done</td><td style="text-align:center">将来完成式<br>will have done</td></tr><tr><td style="text-align:center">完成进行式</td><td style="text-align:center">过去完成进行式<br>had been done</td><td style="text-align:center">现在完成进行式<br>have/has been done</td><td style="text-align:center">将来完成进行式<br>will have been done</td></tr></tbody></table><p>只看表格里的中文名词可能比较难以理解，下面我们把每个时态带入具体场景进行理解：</p><h2 id="一般式"><a href="#一般式" class="headerlink" title="一般式"></a>一般式</h2><p>强调动作本身，即<strong>只强调动作发生的时间，不强调动作的状态</strong>；也就是说说这句话的人只关心这件事发生在过去现在还是将来，而不关心这件事有没有完成。</p><ul><li>一般过去式： <code>sb. did sth.</code><ul><li>表示过去的动作。I <u>got up</u> late this morning.</li><li>表示过去的事实：Colubus <u>discovered</u> America in 1742.</li></ul></li><li>一般现在式：<code>sb. do sth.</code><ul><li>表示事物现在的情况或状态，最典型的就是主系表结构，例如：I <u>am</u> a developer.</li><li>表示经常性、习惯性动作，常伴随时间副词修饰：I never/often/always <u>do</u> sth.</li><li>表示客观真理、格言，如： Time <u>filies</u>.</li></ul></li><li>一般将来式：<code>sb. will do sth.</code> 表示将来的动作、状态或是倾向。<ul><li>Will 表示意愿时，主语是人；表预测时，主语是物：I <u>will do</u> this card tomorrow. This part of the code <u>will become</u> difficult to maintain.</li><li>Be going to + 动词原形，多表计划，主语多为人：I<u>‘m going to</u> have lunch.</li><li>Be about to + 动词原形，表示即将： He <u>is about to</u> leave for a meeting.</li></ul></li></ul><p>对于一般现在式和一般将来式一般不容易犯错误，而容忽略的往往是一般过去式，因为汉语中习惯在动词末加“了”字补充说明这个动作已经发生，而英文则是要在这个动词出现的同时就带出“已经发生”的信息，因此容易被忽略。像说“I breake the pipeline.” ，break 是一个瞬间动词，因此说这句话的时候必然流水线已经红了，就应该用过去式“I <u>broke</u> the pipeline”。</p><h2 id="进行式"><a href="#进行式" class="headerlink" title="进行式"></a>进行式</h2><p>强调动作过程，表示正在做某事。</p><ul><li>过去进行式：<code>sb. was doing sth.</code><ul><li>表示过去正在做某事：I <u>was pairing</u> with Eli when Luke called me.</li></ul></li><li>现在进行式：<code>sb. be doing sth.</code><ul><li>表示现在正在发生的动作：It<u>’s raining</u> heavily now.</li><li>表示即将发生的动作，通常表示“位移”短暂动词 come, go, arrive, leave, start, begin, return, die, take，此时 be 动词译为“即将”：We <u>are going to</u> lunch soon.</li><li>主系表的一般态和进行态区别：主系表句型在口语中常表一般现在时，但如果强调此时的状态，可以用现在进行时。you are very rude! -&gt; you <u>are being</u> very rude! 你现在的行为粗鲁，而不是你这个人。</li></ul></li><li>将来进行式：<code>sb. will be doing sth.</code><ul><li>表示将来某时正在做的事情，强调对动作本身的描写，也是一般态的生动模式。例如：They <u>will be arriving</u> here tomorrow. 如果使用 arrive here 也可以，只是没有那么生动。</li></ul></li></ul><p>进行式容易忽略的一点是<strong>进行式只针对延续性动词</strong>，任何一个进行态的句子都可以改成一般态，但是一般态却必须是延续动词才能改成进行态。比如“结婚”和“开始”就是瞬间动词，中文中常有“他们正在结婚”，“比赛正在开始”的说法，而英文却不能用“They were marrying last week.” 只能说“They <u>married</u> last week.”，或者把“结婚”换成“结婚仪式”，成为延续性动词，用“They <u>are having</u> a wedding ceremony” 来表达正在进行婚礼。</p><h2 id="完成式"><a href="#完成式" class="headerlink" title="完成式"></a>完成式</h2><p>强调动作结果，在表意中时间被弱化，因此很容易忽略时态中的“时”。</p><ul><li>过去完成式：<code>sb. had did sth.</code><ul><li>表示截止到过去某时位置所完成的动作或经验的总结。过去完成时不能单独存在，要与另一使用一般过去时的句子或者表示过去的副词短语连用。had 译为“已经”或”曾经“：I <u>had opened</u> this feature toggle before last release.</li></ul></li><li><p>现在完成式：<code>sb. have/has did sth.</code></p><ul><li>表示到现在为止已经完成的动作（发生时间不明确）：DICE Team <u>has completed</u> the AMI upgrade.</li><li>如果是延续性动词，表示持续到现在的动作或状态：（be 动词是可延续的）Cloud hosting team <u>has been doing</u> SSL upgrade for two weeks.</li><li><p>现在完成时常用时间副词：</p><pre><code>- 自从... since + 时间点- 有若干时间之久… for + 时间段- 到目前为止... so far/up to now- 最近... recently/lately- 一次/两次/几次/多次... once/twice/a few times/many times- 过去若干年/月/日以来... over/during/for + the last/past + 数字 + years/months/days</code></pre></li></ul></li><li><p>未来完成式：<code>sb. will have did sth.</code></p><ul><li>表示到将来某时为止所做完成或仍然继续的动作或经验等。常与介词 by 构成时间状语连用，表示“到…的时候”，表示对将来这个时间点之前的一个或一系列动作的总结：By the end of this iteration, we <u>will have finished</u> work on the new brand.</li></ul></li></ul><p>这是一个充满“have/has”的句式，写邮件的时候很容易忽略三单，例如 Kira <u>has done</u> it  before. 另外，就如开头说的，完成式强调的是结果的状态，因此时间会被弱化，因此要注意根据完成时间在现在时间的前后选择<code>had</code>、<code>have/has</code>、或是<code>will have</code>。</p><h2 id="完成进行式"><a href="#完成进行式" class="headerlink" title="完成进行式"></a>完成进行式</h2><p>同时强调动作的结果和过程，是完成式的延续态，也就是说同样只适用于延续动词，且让这个延续的动作显得更生动，例如：I have work for this account for two years -&gt; I have been working for this account for two years. 两句话意思完全相同，但是第二句更加形象生动。</p><ul><li>过去完成进行式：<code>sb. had been doing sth.</code><ul><li>表达一直继续到过去某时，而当时仍然在继续的动作。过去完成进行时的句中必须有表示过去的时间状语：We <u>had been tracing</u> that bug for 8 hours before another team solved it.</li></ul></li><li>现在完成进行式：<code>sb. have/has been doing sth.</code><ul><li>表示一直继续到现在，且可能继续下去的动作。通常和表示时间段的副词连用，如 for, since, all morning…   Kelly <u>has been working</u> on this card for 28 days.</li></ul></li><li>将来完成进行式：<code>sb. will have been doing sth.</code> 一直持续到将来某时，且可能继续下去的动作多用于叙述性故事中，或间接引语中：He told me that by the end of this year he <u>would have been working</u> at ThoughtWorks for 5 years.</li></ul><p>这个也算是很常用的时态，尤其是表示”这个东西我做了一段时间了，现在也仍在做的时候，要用现在完成进行式，同样注意第三人称单数。</p><hr><h2 id="过去将来时"><a href="#过去将来时" class="headerlink" title="过去将来时"></a>过去将来时</h2><p>除了以上提到的十二中时态，还有一个稍微特殊的时间叫做<strong>“过去将来”</strong>，指的是“站在过去看将来”，其用法与将来时只有一个差别，就是把“will”换成“would”：</p><ul><li>一般过去式：<code>sb. would do sth.</code><ul><li>站在某个过去的时间点看将会发生的动作：He told me he <u>would do</u> it as quick as possible.</li></ul></li><li>过去将来进行式：<code>sb. would be doing sth.</code><ul><li>站在某个过去的时间点，从这个时间点看一个之后的时间点（或时间段）正在发生的动作：He knew that I <u>would be living</u> in Melburne next month.</li></ul></li><li>过去将来完成式：<code>sb. would have done sth.</code><ul><li>站在某个过去的时间点，对一个之后的时间点已经发生了的动作做总结：WaterStrong said he <u>would have left</u> for Sydney by the end of next month.</li></ul></li><li>过去将来完成进行式：<code>sb. would have been doing sth.</code><ul><li>站在过去的某个时间点，对一个之后的时间点正在发生的动作做总结：I knew by July Jimmy <u>would have been working</u> there for 3 years.</li></ul></li></ul><p>在读书的时候会比较多出现这个时态，类比将来式的使用即可。</p><blockquote><p>References:</p><ul><li><a href="https://zhuanlan.zhihu.com/p/27786339" target="_blank" rel="noopener">知乎专栏：如何快速掌握英语的十六类时态？</a></li></ul></blockquote>]]></content>
    
    <summary type="html">


        &lt;p&gt;来 ThoughtWorks 两年了，英文使用也两年了，日常和工作中的交流几乎是没有问题，但是在说和写的时候总还觉得不地道，要么太啰嗦，要么说着说着逻辑就乱了，有时甚至感觉说英文像是在堆砌单词。最近补了一下英文语法，发现用错时态是我日常交流中最容易犯的错误，特此组织成文，方
      
    
    </summary>
    
      <category term="English" scheme="https://www.duyidong.com/categories/English/"/>
    
    
      <category term="学习" scheme="https://www.duyidong.com/tags/%E5%AD%A6%E4%B9%A0/"/>
    
      <category term="英文" scheme="https://www.duyidong.com/tags/%E8%8B%B1%E6%96%87/"/>
    
  </entry>
  
  <entry>
    <title>在 AWS 流水线中使用 CodeDeploy</title>
    <link href="https://www.duyidong.com/2018/02/26/aws-codedeploy/"/>
    <id>https://www.duyidong.com/2018/02/26/aws-codedeploy/</id>
    <published>2018-02-27T06:24:39.000Z</published>
    <updated>2018-02-27T01:27:05.000Z</updated>
    
    <content type="html"><![CDATA[<p>AWS 为开发者提供了 CodeCommit -&gt; CodeBuild -&gt; CodeDeploy 三个服务分别用于管理应用的代码库、构建、部署三个环节，并使用 CodePipline 编排流水线，以及使用 CodeStar 以快速构建模板项目。</p><p><img src="/images/aws-pipeline.png" alt=""></p><h1 id="AWS-上的流水线"><a href="#AWS-上的流水线" class="headerlink" title="AWS 上的流水线"></a>AWS 上的流水线</h1><p>CodeCommit 是一个私有的 git 代码版本管理库，CodeBuild 是一个基于 Docker 的构建环境，可以用一个叫<code>buildspec.yml</code>的 Yaml 配置文件定义构建规则（其实跟 Bash 脚本没啥区别），CodePipeline 是用于串联各个 Stage，这些都没啥新鲜的，对 AWS 而言，值得一书的恐怕还属 CodeDeploy。</p><h1 id="CodeDeploy-介绍"><a href="#CodeDeploy-介绍" class="headerlink" title="CodeDeploy 介绍"></a>CodeDeploy 介绍</h1><p>CodeDeploy 在产品生命周期中掌管部署环节，支持 EC2 和 Lambda，亮点是和 AWS 其他服务高度集成，提供零宕机部署（包括蓝绿部署）。CodeDeploy 的规则定义起来比较简单，还可以和 Puppet/Chef 集成，但是需要对 AWS 的基础服务比如 EC2、ASG、ELB、S3 比较了解，上手难度并不大。本文主要解释基于 EC2 的 CodeDeploy 使用。</p><h2 id="概念解释"><a href="#概念解释" class="headerlink" title="概念解释"></a>概念解释</h2><p>AWS  CodeDedeploy 定义了一些资源名称：</p><ul><li><strong>Application:</strong> 一个应用，也对应项目里一个 Project，一般对应一个代码仓库，包含多个环境。可以定义多个<strong>Deployment Groups</strong>。</li><li><strong>Deployment Groups:</strong> 对应应用的一个环境，包含了 instance 选区规则（Tag/ASG）、ELB、触发规则、Rollback 策略、权限（Role）以及 <strong>Deployment Configuration</strong>。</li><li><strong>Deployment Configuration:</strong> 部署策略，有 AllAtOnce、HalfAtATime、OneAtATime 三种默认策略，也支持自己定制，即指定在部署过程中一个 Deployment Groups 至少有多少个（百分比）的 instance 要在服务中。</li><li><strong>Revision:</strong>一个新版本及为一个 Revision，需要提供 Repo（S3/Github）、Deployment Configuration、Rollback 策略等信息。</li></ul><h2 id="触发"><a href="#触发" class="headerlink" title="触发"></a>触发</h2><p>CodeDeploy 的对象可以来自 S3 或者 Github，和所有的 AWS 资源对象操作一样，Trigger 方式可以选择 Console、cli、或是 sdk。 </p><h3 id="手动触发"><a href="#手动触发" class="headerlink" title="手动触发"></a>手动触发</h3><p>触发相关的设置在 <strong>Deployment Groups</strong> 中，选择<strong>Deploy new revision</strong>，这里有两个可选方式：</p><ul><li>S3 object + ETag: 被部署的文件必须被打包为一个文件（<code>.zip</code>或是 <code>.tar</code>）并上传到 S3 上，ETag 是该文件的一个哈希，会随文件变更改变，因此 Revision 里面实际上带了文件位置和版本号两个信息。</li><li>Github repository + commit ID: 与 S3 一样，信息需要定位到 Repo + 版本号，不同的是 Github 不需要把部署文件和部署脚本一起打包，另外第一次使用这个功能需要 Github 授权给 AWS CodeDeploy。</li></ul><h3 id="命令行-Deploy-to-S3-触发"><a href="#命令行-Deploy-to-S3-触发" class="headerlink" title="命令行 Deploy to S3 触发"></a>命令行 Deploy to S3 触发</h3><p>AWS CLI 有一个 Deploy 的 namespace 可以用来触发 Application Deploy，对于 S3 参数如下：</p><pre><code>aws deploy register-application-revision --application-name DemoApp --s3-location bundleType=tar,eTag=0d088076b9baa9bd71369367119e6b33,bucket=yidong-codedeploy,key=demoRevision.tar</code></pre><p>Github 如下：</p><pre><code>aws deploy register-application-revision —application-name DemoApp —github-location commitID=&lt;value&gt;,repository=adu-21/aws-codedeploy</code></pre><p>如果被部署文件在本地而还没有提交到 S3 可以使用 <code>aws deploy publish</code>一键打包、上传、发布：</p><pre><code>aws deploy push --application-name DemoApp --ignore-hidden-files --s3-location s3://yidong-codedeploy/newDemoRevision.zip --source .</code></pre><h3 id="Github-提交自动触发"><a href="#Github-提交自动触发" class="headerlink" title="Github 提交自动触发"></a>Github 提交自动触发</h3><p>Github 的集成可以做到部署文件提交到 Github 上就有一个 Webhook 到 CodeDeploy，并 Pull 最新版代码到 instance 上，需要给 CodeDeploy 配置 Github 账户 <code>repo_deployment</code>权限的 <strong>access token</strong>，并在 Repo 的 <strong>Services</strong> 中加入 AWS CodeDeploy 和 Github Auto-deployment 两个服务，具体可见：<a href="https://github.com/ADU-21/aws-codedeploy/settings/installations" target="_blank" rel="noopener">https://github.com/ADU-21/aws-codedeploy/settings/installations</a>：</p><p><img src="/images/aws-codedeploy-setting.png" alt=""></p><h2 id="执行"><a href="#执行" class="headerlink" title="执行"></a>执行</h2><p>Deploy 执行的逻辑写在被部署文件根目录的一个 <code>appspec.yml</code>文件中，参见：<a href="https://github.com/ADU-21/aws-codedeploy/blob/master/appspec.yml" target="_blank" rel="noopener">https://github.com/ADU-21/aws-codedeploy/blob/master/appspec.yml</a>:</p><pre><code>version: 0.0                              # 版本号os: linux                                 # 操作系统，只有 linux 和 windows 两个可选项files:                                    # 定义某个本地文件拷贝到目标服务器的某个地址  - source: files/index.html    destination: /var/www/htmlpermissions:                              # 目标服务器上文件权限  - object: /var/www/html    pattern: index.html    owner: apache    group: apache    mode: 644    type:      - filehooks:                                     # 定义部署前后的一系列流程，通常调用本地完成  BeforeInstall:    - location: scripts/webserver-stop.sh    - location: scripts/delete-old-index.sh  AfterInstall:    - location: scripts/sleep.sh    - location: scripts/webserver-start.sh</code></pre><p>对于 Hook 模块，有 ELB 的和没有 ELB 的有以下可选子模块：</p><p><img src="https://docs.aws.amazon.com/codedeploy/latest/userguide/images/lifecycle-event-order-in-place.png" alt=""></p><center><strong>图片来自：<a href="https://docs.aws.amazon.com/codedeploy/latest/userguide/reference-appspec-file-structure-hooks.html" target="_blank" rel="noopener">官方文档</a></strong></center><h2 id="蓝绿部署"><a href="#蓝绿部署" class="headerlink" title="蓝绿部署"></a>蓝绿部署</h2><p>AWS CodeDeploy 提供配置简单的 Blue/Green Deploy 服务，只需要配置 ELB 和 ASG 就可以完成自动创建新环境、Switch ELB、Terminate 旧环境几个步骤（如下图），完整步骤详见<a href="https://aws.amazon.com/blogs/devops/performing-bluegreen-deployments-with-aws-codedeploy-and-auto-scaling-groups/" target="_blank" rel="noopener">官方博客</a>。</p><p><img src="https://d2908q01vomqb2.cloudfront.net/7719a1c782a1ba91c031a682a0a2f8658209adbf/2017/04/19/codedeployresults.png" alt=""></p><center>图片来自：<a href="https://aws.amazon.com/blogs/devops/performing-bluegreen-deployments-with-aws-codedeploy-and-auto-scaling-groups/" target="_blank" rel="noopener">Performing Blue/Green Deployments with AWS CodeDeploy and Auto Scaling Groups</a></center><h1 id="后记"><a href="#后记" class="headerlink" title="后记"></a>后记</h1><p>今年 AWS 发布财报营收已经被微软超越。亚马逊的产品不得不说性能稳定性强大，但是易用性和商业模式上仍不及国内阿里、腾讯的产品，甚至不如 Rancher、Hashicorp 这样一些小公司的产品简洁、易上手。过去的一年在各种 PaaS 的竞争中 AWS 逐渐面临被 IaaS 化的命运，投资数年的 Serverless 因为它的不稳定、不成熟和平台绑定，在过去的几年中鲜有公司真正涉足，大多在观望状态。就我个人的使用体验而言，Serverless 的架构在较复杂的业务场景下对架构会带来非常大的挑战，资费优势也被 AWS 抖机灵的收费方式蚕食殆尽，17 年 AWS 收购 Cloud9 及迅速提升 Developer Tools 板块服务的行为就是想要补足 PaaS 这块短板。</p><p>我一直觉得像 FLAG（Facebook，LinkedIn，Amazon，Google）这种大公司，在如此体量的前提下还面临大量的服务更新和创新需求，还要求内部协作和资源共享，在多年的摸索中已经有了一套很好用的内部工具链，做 PaaS 只取决于你要如何以及以何种方式把这些工具公开出来。互联网的普及越来越广，企业越来越需要平台来支撑可持续、快速的迭代能力，大企业基于开源项目自建平台，小公司就向大公司租用 PaaS 服务。对讲求效率的小公司而言，一切非业务核心的技术能买则买，能外包就外包，能花钱的解决的问题，决不要花时间。</p><p>PaaS 仍然是很有潜力的一片蓝海，今年可以看到以阿里云效为代表的 DevOps 平台已经在发力，未来必然可以看到更加成熟的产品。</p>]]></content>
    
    <summary type="html">


        &lt;p&gt;AWS 为开发者提供了 CodeCommit -&amp;gt; CodeBuild -&amp;gt; CodeDeploy 三个服务分别用于管理应用的代码库、构建、部署三个环节，并使用 CodePipline 编排流水线，以及使用 CodeStar 以快速构建模板项目。&lt;/p&gt;
&lt;p&gt;
      
    
    </summary>
    
      <category term="Amazon Web Services" scheme="https://www.duyidong.com/categories/Amazon-Web-Services/"/>
    
    
      <category term="AWS" scheme="https://www.duyidong.com/tags/AWS/"/>
    
      <category term="小计" scheme="https://www.duyidong.com/tags/%E5%B0%8F%E8%AE%A1/"/>
    
      <category term="工具" scheme="https://www.duyidong.com/tags/%E5%B7%A5%E5%85%B7/"/>
    
      <category term="Cloud" scheme="https://www.duyidong.com/tags/Cloud/"/>
    
      <category term="Pipeline" scheme="https://www.duyidong.com/tags/Pipeline/"/>
    
  </entry>
  
</feed>